逆向工程
逆向工程是基于数据库模式搭建 JPA 实体类的过程。
从数据库生成实体
确保 IntelliJ IDEA 已 连接到数据库。
打开 Database 工具窗口,右键点击数据库,然后选择
 从数据库创建实体……。
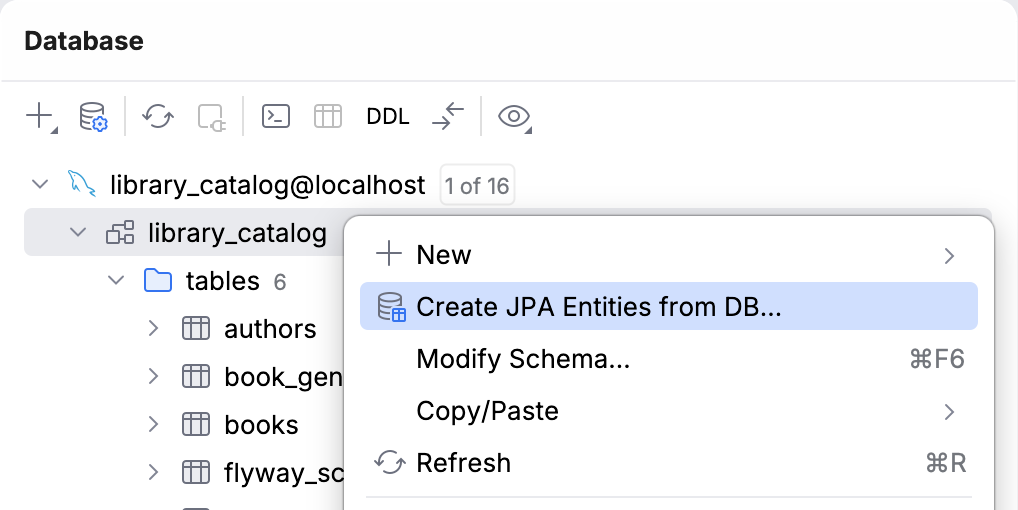
或者,打开 Persistence 工具窗口,右键点击持久化单元或映射上下文,然后选择
 新建 | 来自数据库的实体……。
在打开的 从数据库获取实体对话框中,配置实体映射并点击 OK。
逆向工程列
一些开发者更喜欢 DB-first 应用程序开发方法。 首先, 他们直接向数据库添加列,然后更新 JPA 模型。 IntelliJ IDEA 可以自动化此过程。
从数据库生成实体特性
确保 IntelliJ IDEA 已 连接到数据库。
打开 数据库工具窗口,右键点击一个表,然后选择
从数据库创建实体特性…。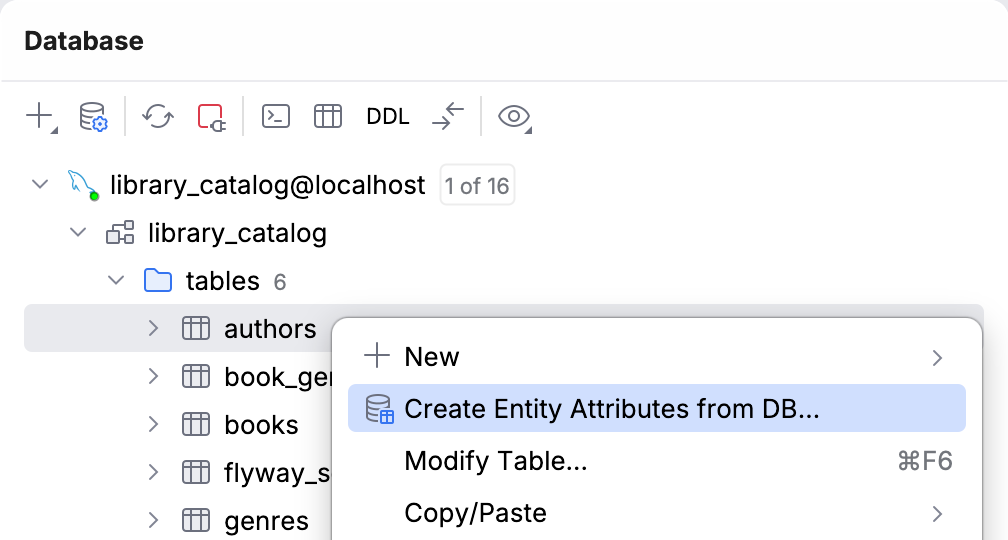
或者,打开 Persistence 工具窗口,右键点击实体,然后选择
新建 | 来自数据库的实体特性。
在打开的 从数据库获取实体对话框中,配置实体映射并点击 OK。
智能引用检测
IntelliJ IDEA 深刻理解您的模型。 在某些情况下,可以正确检测基数: @OneToOne、 @OneToMany、 @ManyToOne、 @ManyToMany。 最酷的是,IntelliJ IDEA 即使在当前表格中没有相应列的情况下也能显示引用。
让我们更仔细地看看这些情况。
@OneToOne
在两种情况下,我们可以自信地假设关系的基数为 @OneToOne:
表中有一列带有唯一约束,引用了另一个表的主键
表的主键是外键
情况 1:
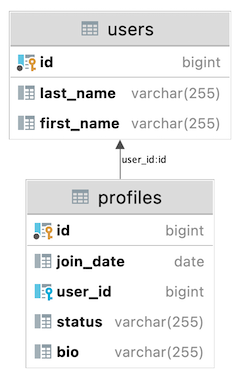
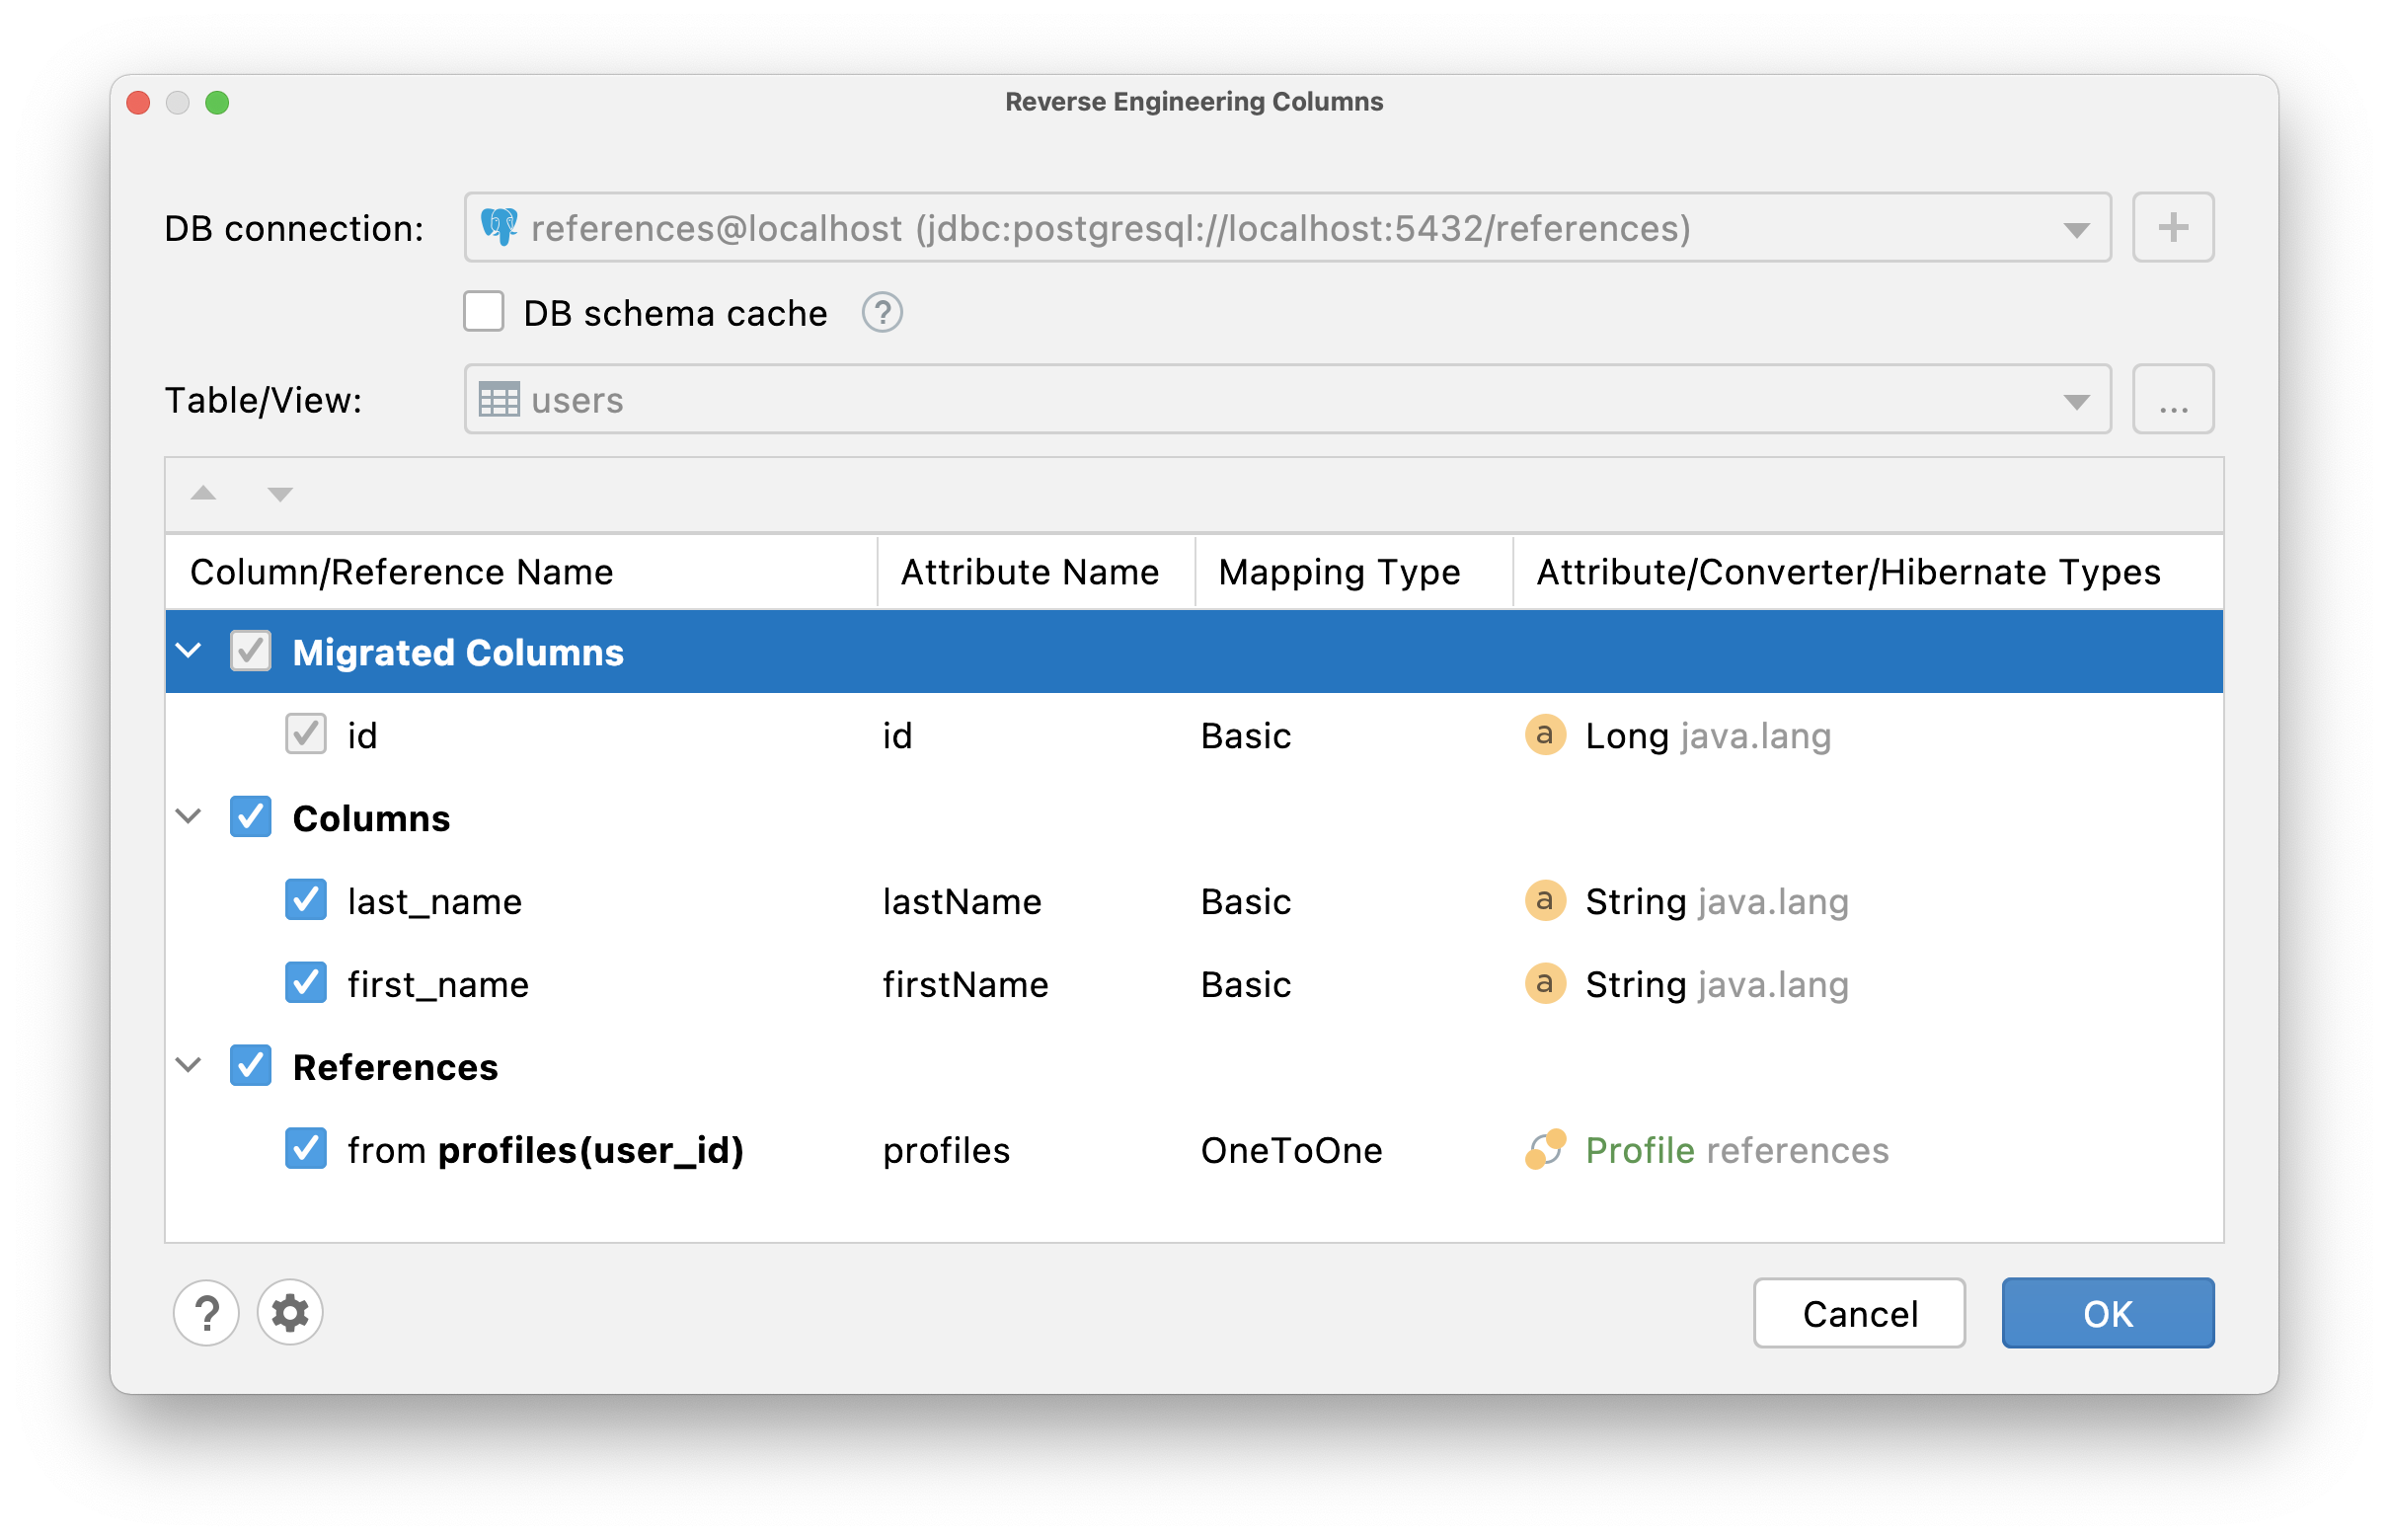
IntelliJ IDEA将在 User 实体中生成一个 @OneToOne 关联,具有一个 @JoinColumn 注解,并在 Profile 实体中生成一个 @OneToOne 关联,具有一个 mappedBy 参数:
案例编号 2:
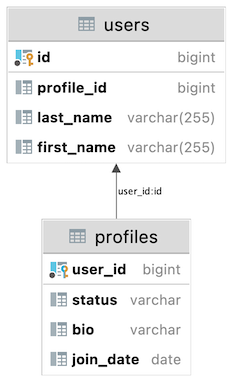
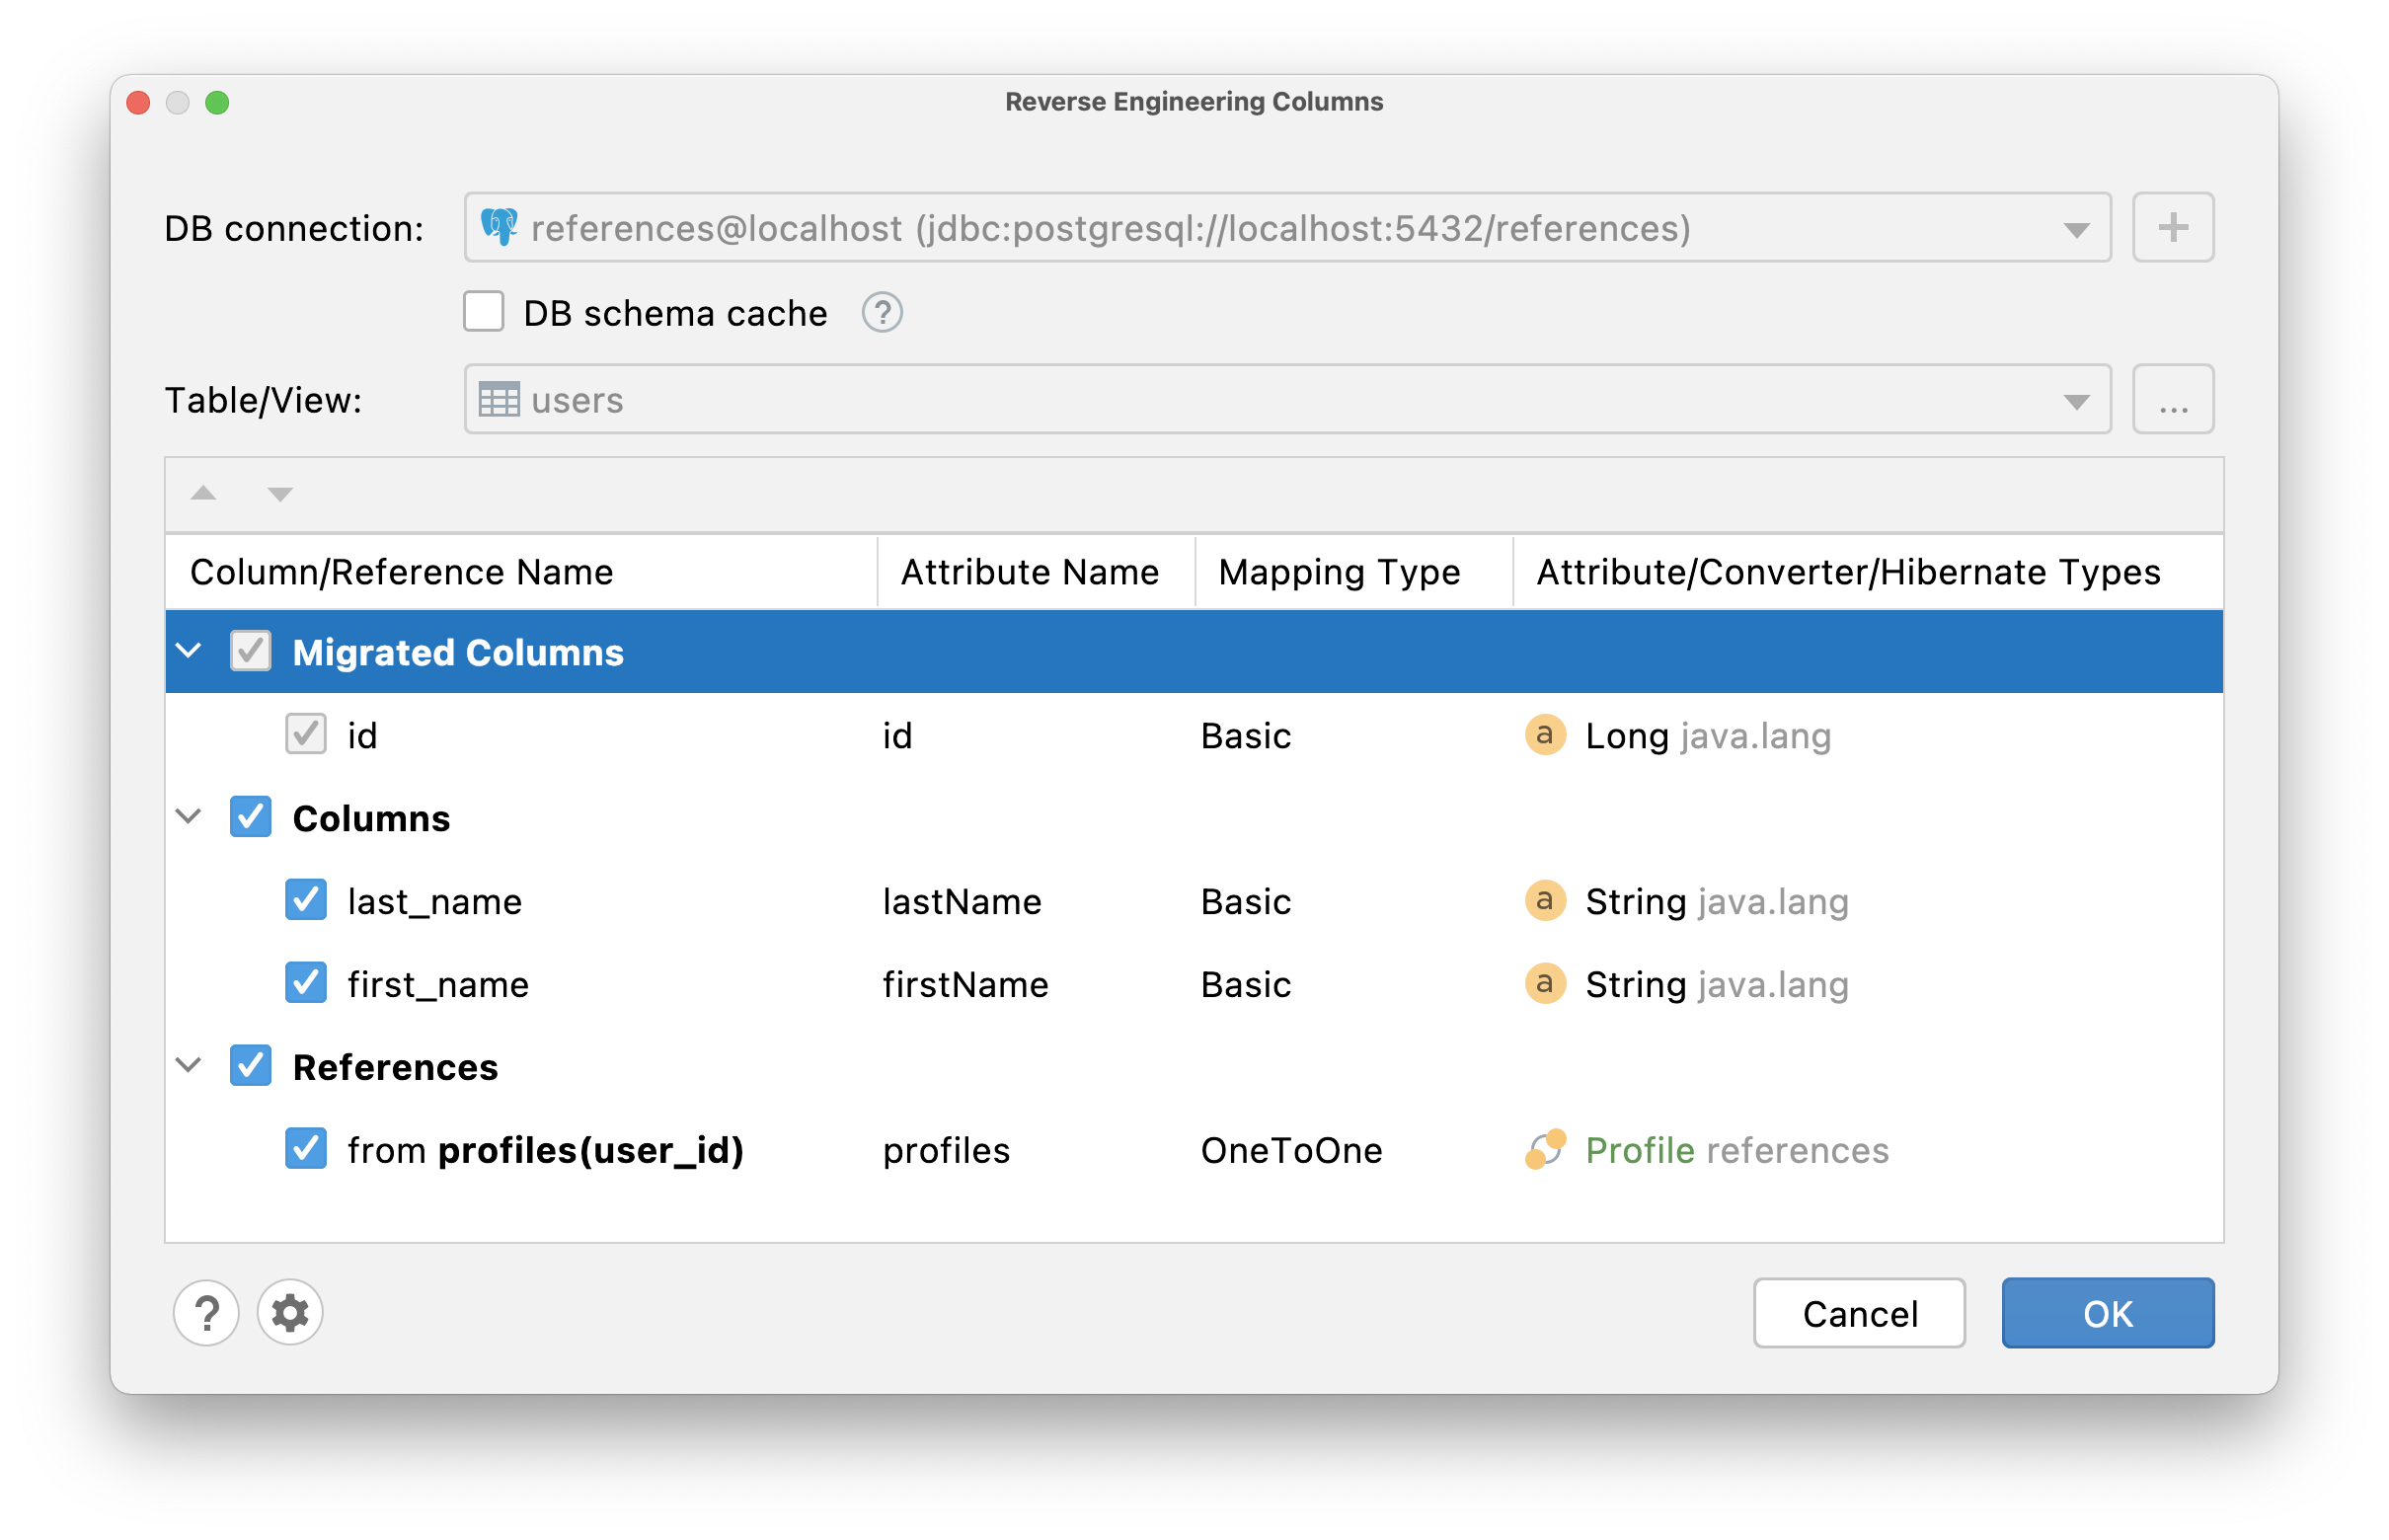
由于 @Id 不应是持久化实体,IntelliJ IDEA 将生成:
基本类型的
id属性并使用@Id注解对其进行标记users@OneToOne关联并使用@MapsId注解标记
@OneToMany & @ManyToOne
如果一个表具有指向另一个表的主键的列,则很可能是一个 @ManyToOne 关联。 但是您也可以根据需要将基数更改为 @OneToOne。 因此,取决于您在哪个表上调用反向工程操作,IntelliJ IDEA 将检测映射类型为 @OneToMany 或 @ManyToOne:
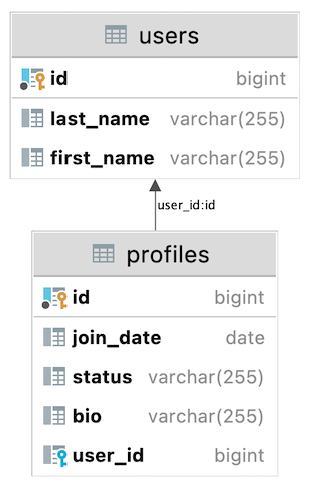
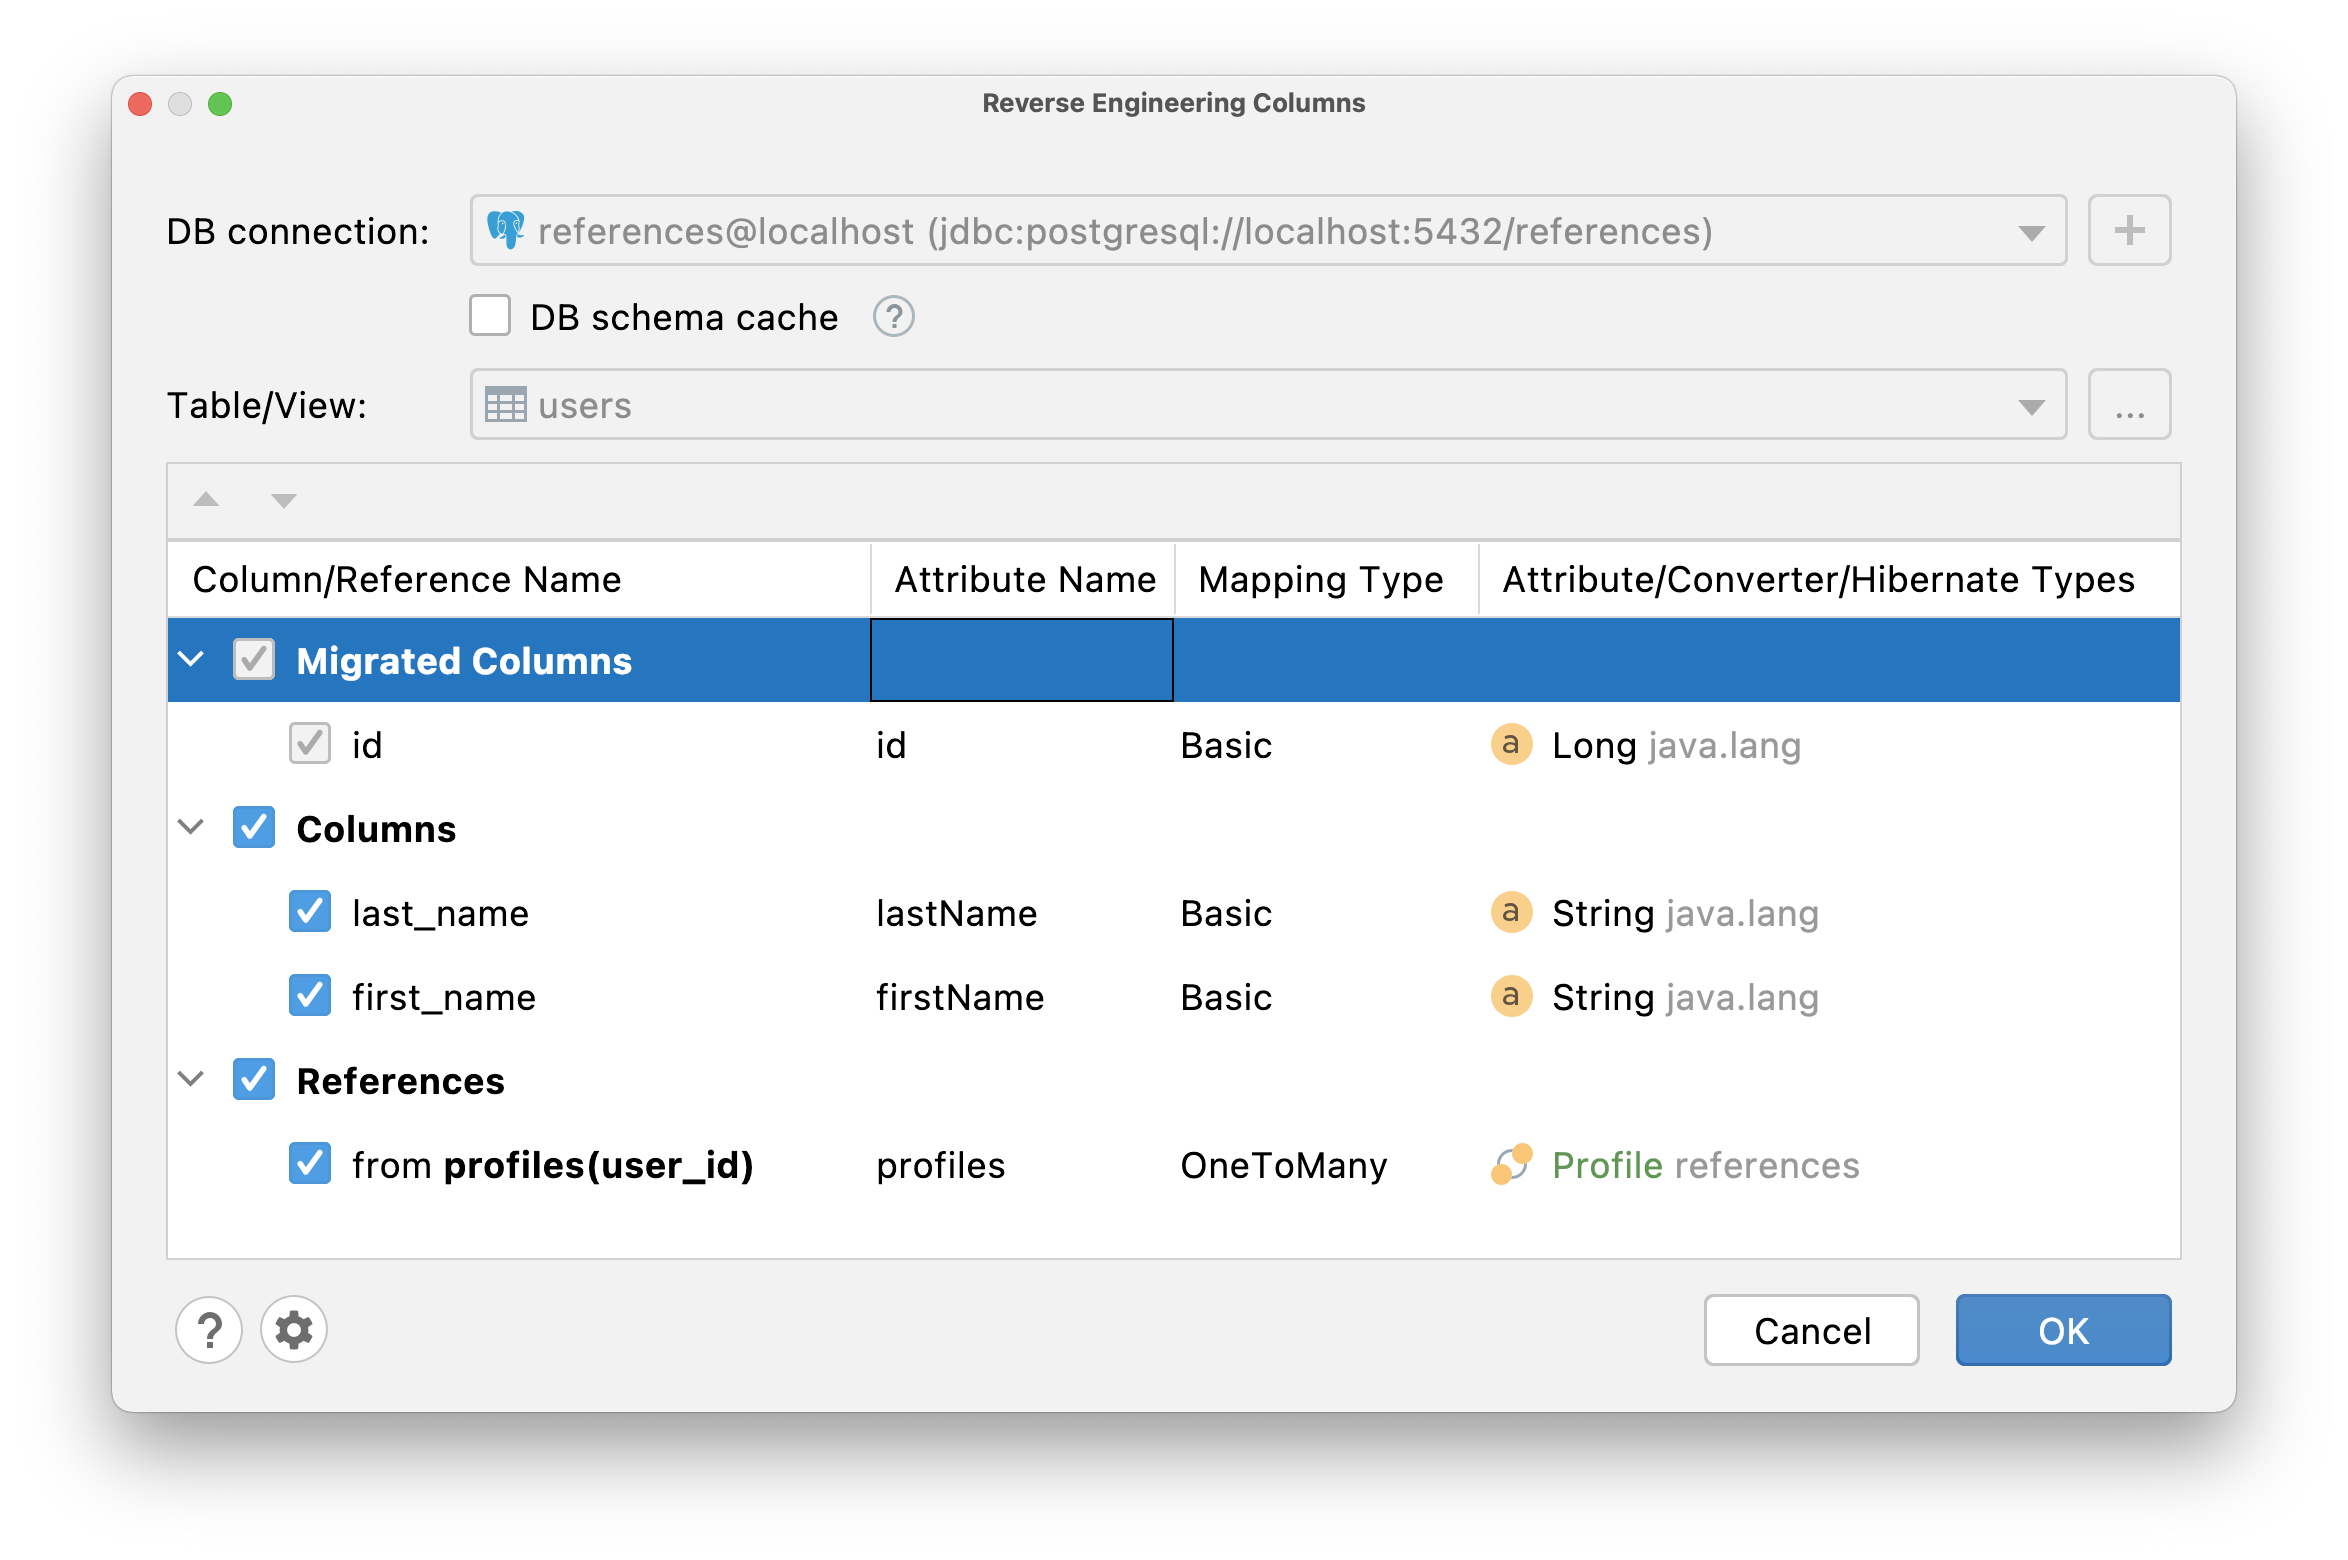
IntelliJ IDEA 将生成以下代码:
@ManyToMany
要在两张表之间建立多对多关系,您需要使用连接表。 在这种情况下,连接表只包含两列——外键。 IntelliJ IDEA 能够自动检测这样的表,并识别两个表之间的关系基数,这两个表的 ids 在连接表中表示为外键,如 @ManyToMany。
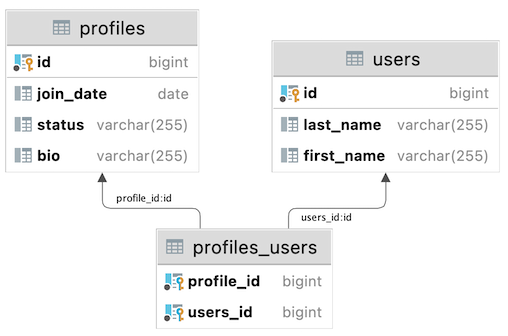
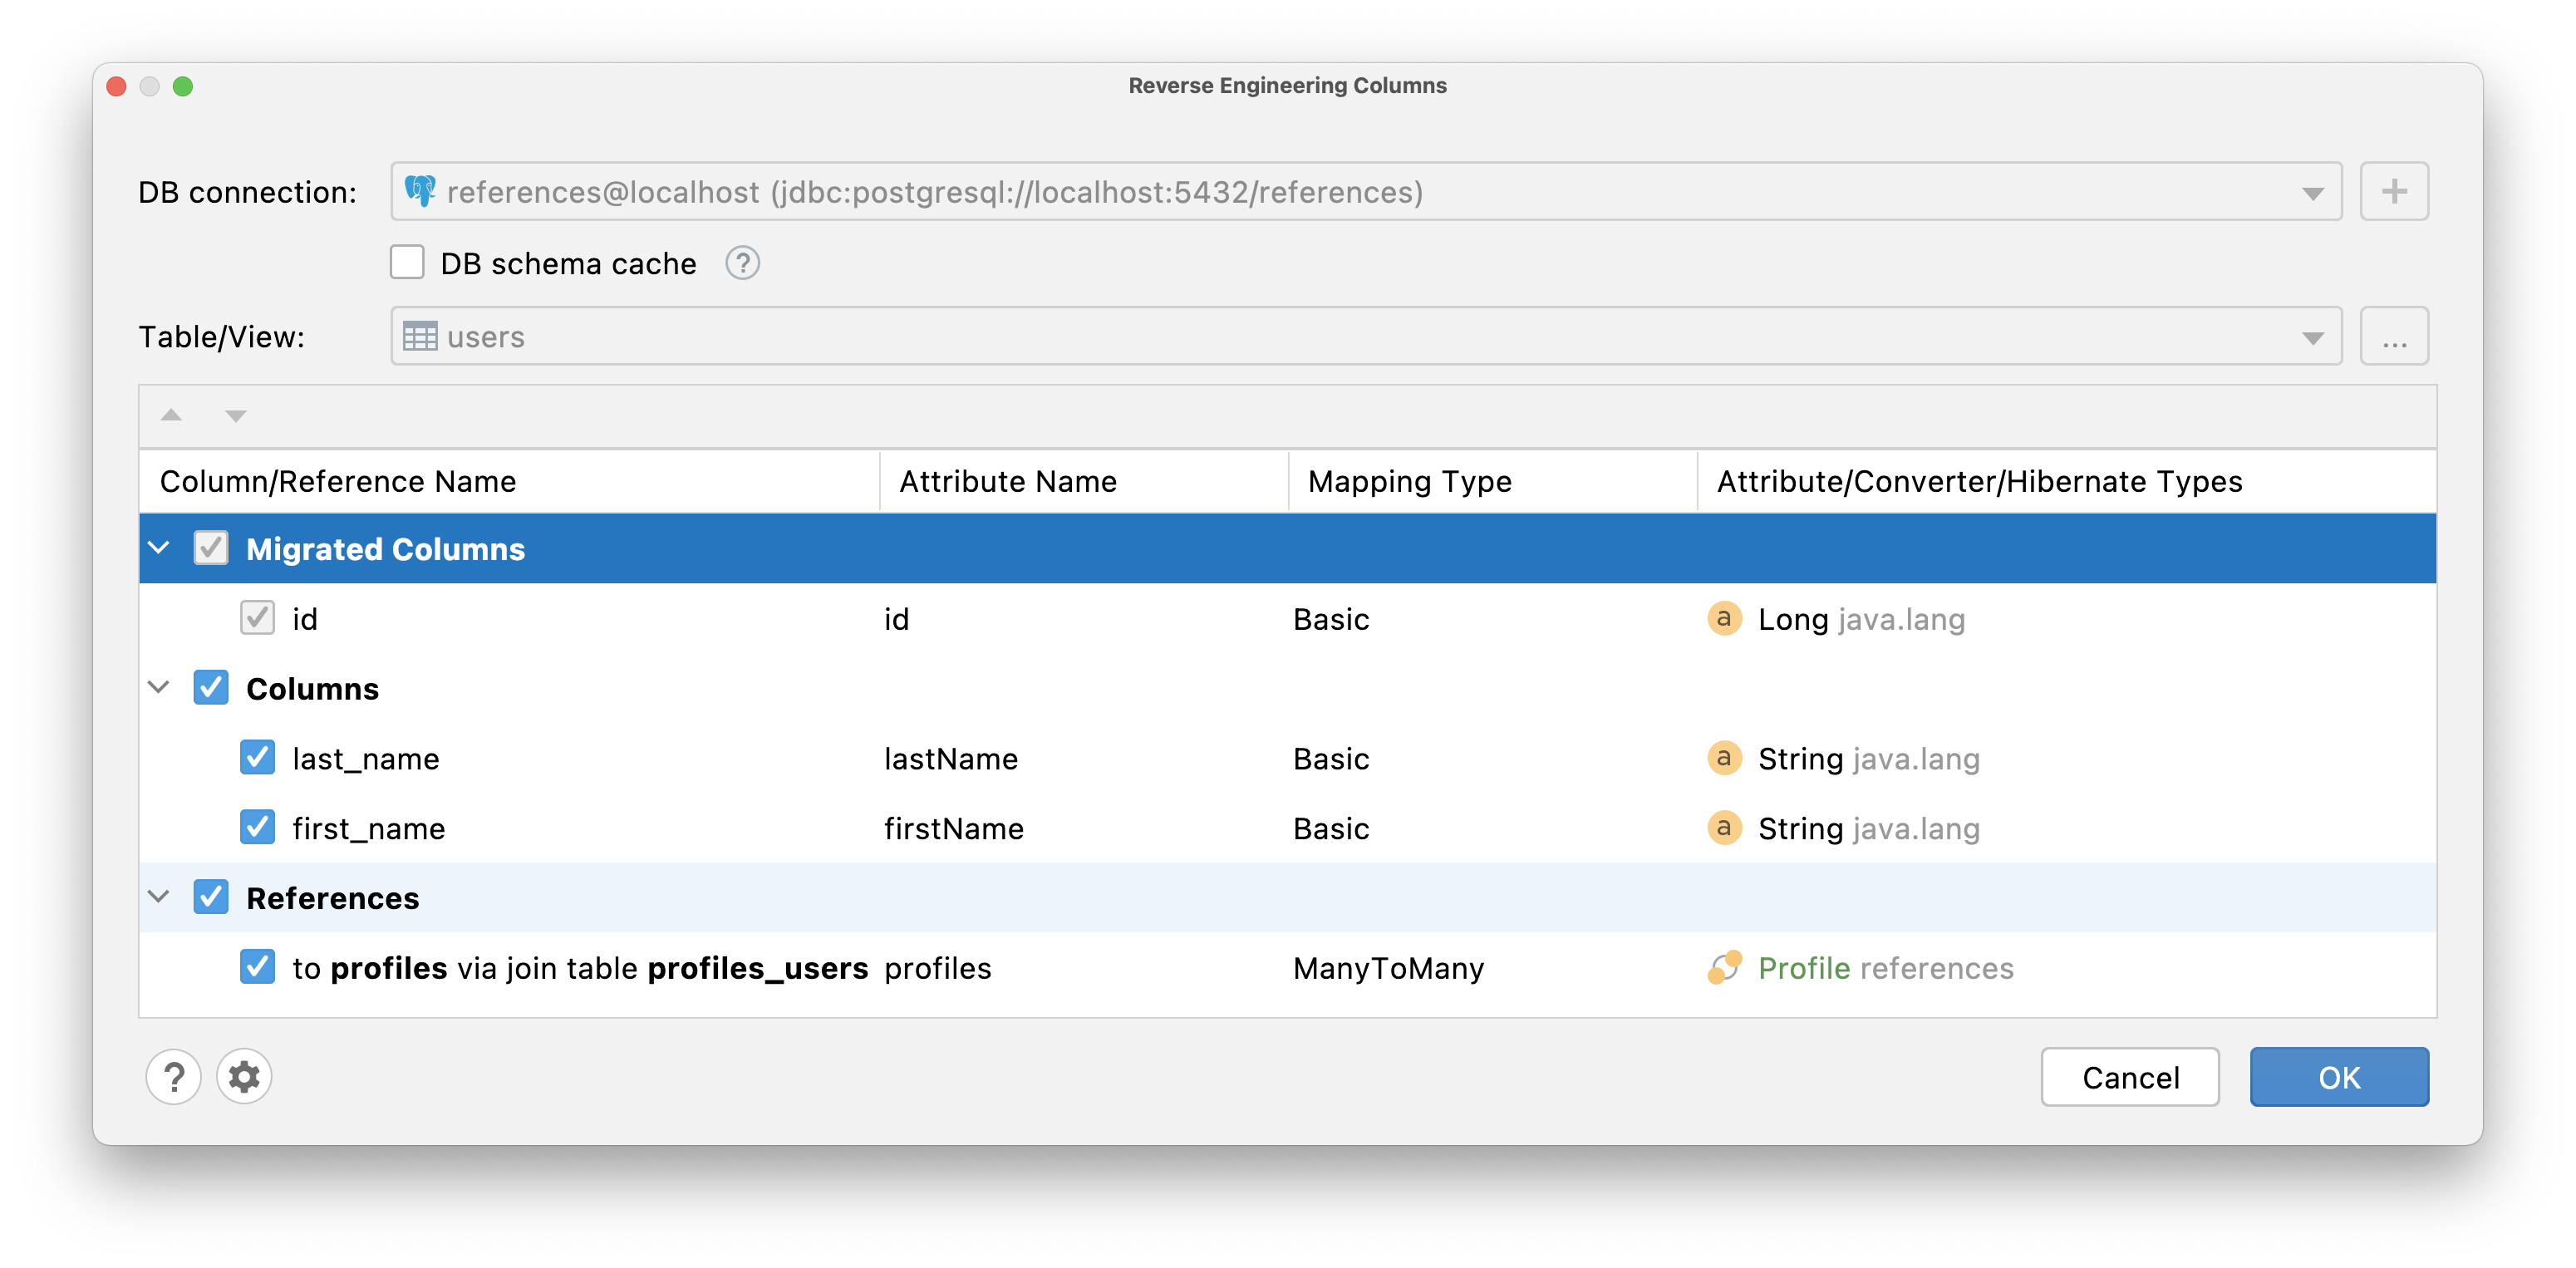
如果任何实体中不存在此关联,IntelliJ IDEA 将在调用反向工程操作的实体中生成该关联。
如果此关联已经存在于其中一个实体中,那么 IntelliJ IDEA 将生成带有 @ManyToMany 属性和 mappedBy 参数的属性。
视频教程
以下视频演示了在映射需要一些额外配置时如何对数据库架构进行逆向工程。
- 对 JPA 实体进行逆向工程并使其继承自父类
IntelliJ IDEA 提供通过从
@MappedSuperclass注释的类中选择一个类以定义父实体的功能,这可以在 父项 下拉框中完成。 这允许生成的实体扩展自父类,并自动继承所有具有相同名称和类型的属性。在
@MappedSuperclass中的列名与子实体的表不匹配的情况下,我们仍然可以使用@AttributeOverride注解继承该属性。 只需选择特性名称并选择要重写的项,IntelliJ IDEA 即可帮助管理继承。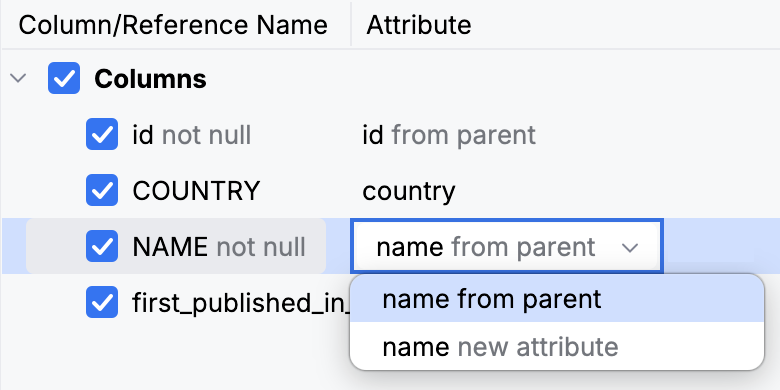
在生成实体期间,IntelliJ IDEA 如果检测到数据库中缺少来自
@MappedSuperclass的任何继承属性,会发出警报。 要使模型与数据库对齐,请访问 JPA Structure 菜单中的 通过实体生成 DDL 操作并选择 现有数据库更新 选项。- 将数据库特定的列类型映射到实体特性
对于某些 SQL 类型,没有与 Java 类完全匹配的对应关系。 在这种情况下,IntelliJ IDEA 不会设置类型,以防生成无法工作的编码。 您需要自己选择属性类型。 也可以在 参考:JPA 逆向工程设置 中为每个 DBMS 配置默认类型映射。
如果项目依赖项列表中包含 HibernateTypes 库 ,IntelliJ IDEA 可以在逆向工程期间自动从该库为不支持的 SQL 类型建议合适的类型:
- 将数据库视图映射到实体
IntelliJ IDEA 遵循所有最佳做法,在逆向工程时为 DB 视图提供最高效的映射:
由于数据库视图没有主键,IntelliJ IDEA 允许您选择一个字段或一组字段作为目标实体的标识符。
大多数 DB 视图是不可变的。 因此,IntelliJ IDEA 会向实体添加
@Immutable注解,并且仅生成 getter。 这有助于提高应用程序性能。IntelliJ IDEA 仅为映射到数据库视图的实体生成无参 protected 构造函数,符合 JPA 规范,这可防止开发者在业务逻辑编码中创建此类实体的新实例。
参考:从数据库创建实体对话框
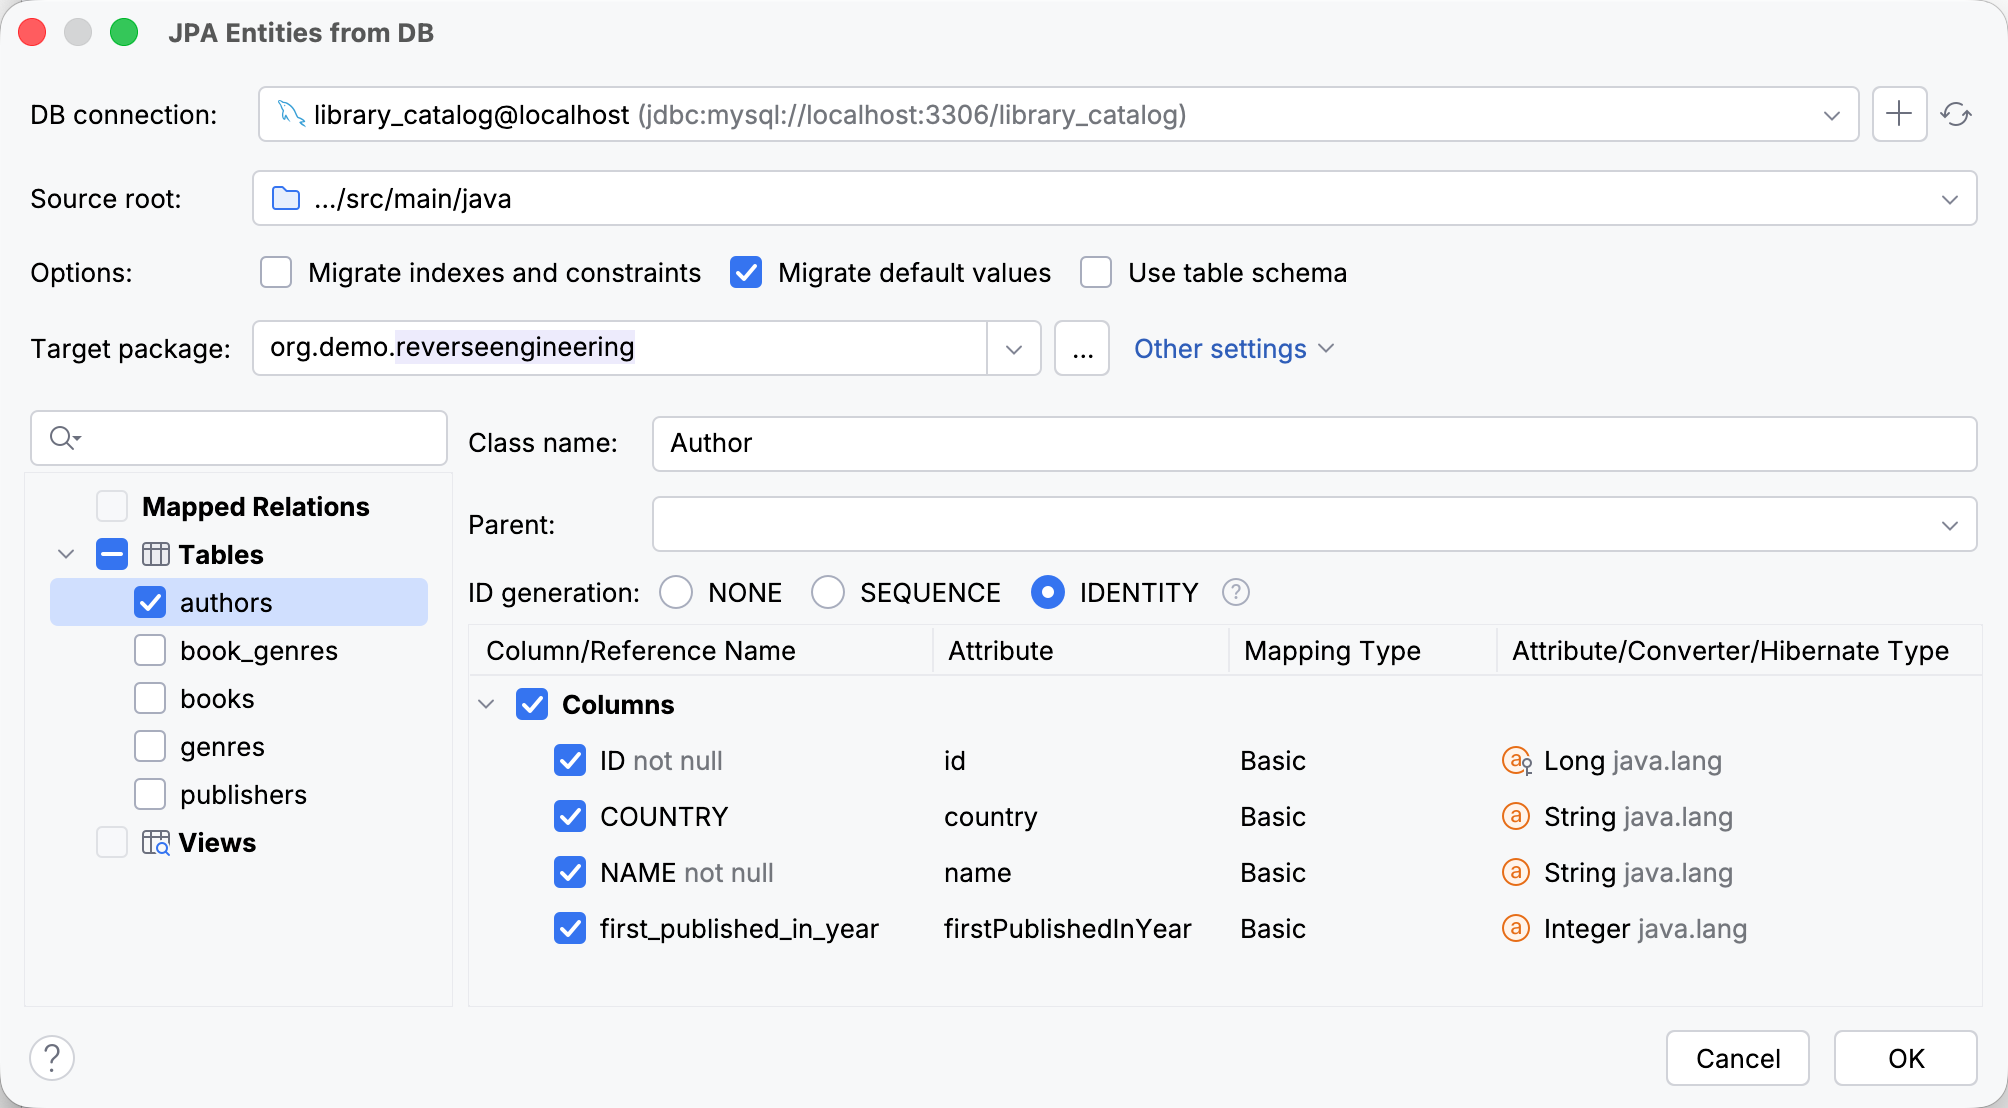
来自数据库的 JPA 实体 对话框可让你将数据库表和视图映射到 JPA 或 Spring Data JPA 实体。
来自数据库的 JDBC 实体 对话框可让你将数据库表映射到 Spring Data JDBC 实体。
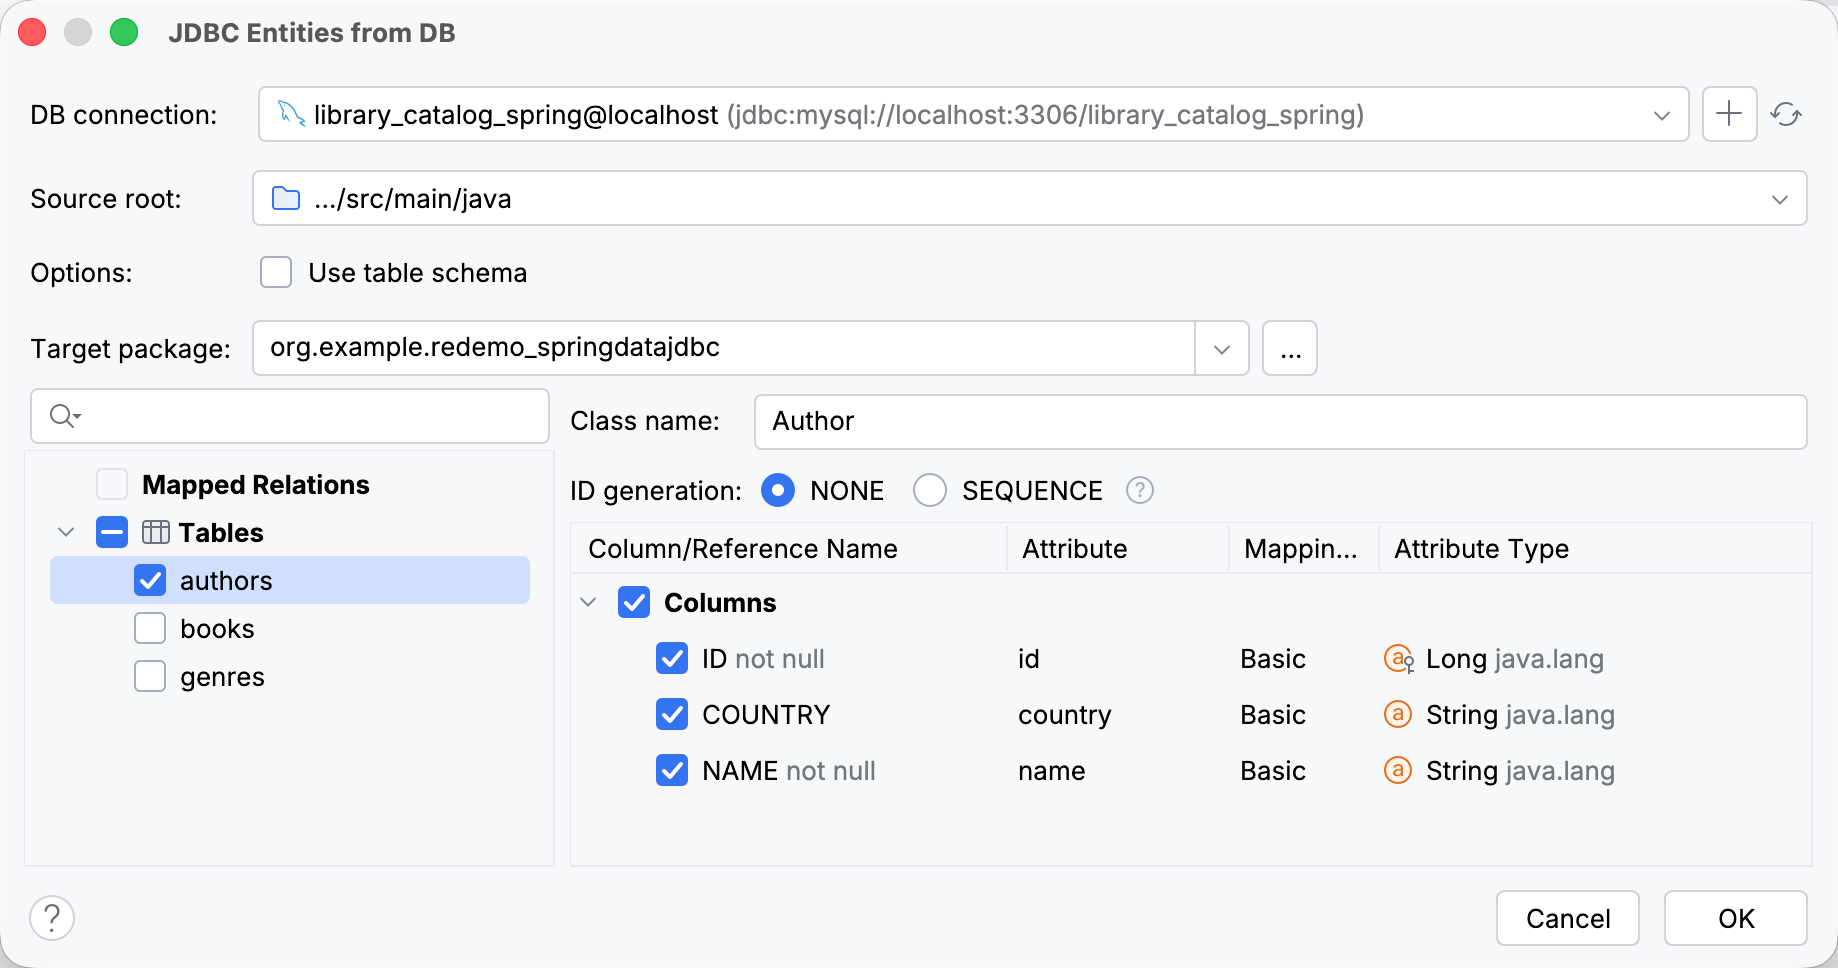
常规选项
对话框顶部显示适用于所有生成的实体类的选项:
条目 | 描述 |
|---|---|
数据库连接 | 选择要进行逆向工程的数据库架构。 需从 数据库 工具窗口选择现有 数据源 ,或点击 |
源根 | 选择一个 源根 ,用于保存生成的实体类。 |
选项 | 选择要包含在生成的实体类中的其他数据:
|
目标软件包 | 选择一个 软件包 ,用于保存生成的实体类。 |
其他设置 | 打开 JPA 逆向工程设置。 |
语言 | 选择应使用 Java 还是 Kotlin 生成实体类。 |
 新建。

实体映射选项
对话框左下方列出所选数据库中的表和视图,并按类型和当前映射状态分组:
映射的关系 :已映射到实体的表和视图。 未完全映射的项带有 未映射的列标签。
表 :未映射到任何实体的表。
视图 :未映射到任何实体的视图。
选择表、视图或关系时,对话框右下方会列出其可映射元素,并同样按状态分组:
映射的列 :已映射到实体特性的列。
列 :未映射到任何实体特性的列。
引用: 其他表中指向此表且未映射到此表实体中任何特性的外部密钥。
对于每个可映射项,对话框会显示以下选项:
条目 | 描述 |
|---|---|
类名 | 指定生成的实体类的名称。 IntelliJ IDEA 会根据表名称和 JPA 逆向工程设置自动填充此值。 |
父项 | 选择一个 映射超类 ,作为生成的实体类的父类。 |
ID 生成 | 选择主密钥的 ID 生成策略:
从 官方 Hibernate 文档详细了解 ID 生成策略。 |
ID 列 | 选择哪些列应被视为主键列。 |
列/引用名 | 所选表或视图中的列名称以及其他表中对其的引用,均为只读。 使用复选框选择要进行逆向工程的列和引用。 |
特性 | 为生成的实体字段指定名称。 IntelliJ IDEA 会根据列名称以及适用时的 JPA 逆向工程设置自动填充这些值。 如果指定了父类,可以针对每个匹配的列决定是从父类继承其特性,还是生成新的特性。 如果继承的特性不是完全匹配,实体将使用 @AttributeOverride 注解。 |
映射类型 | 选择如何将列或引用映射到实体特性。 有关所有可用值的描述,请参阅 可用的映射类型。 |
特性/转换器/Hibernate 类型 | 选择用于生成的实体字段的特性类型、JPA 特性转换器或 Hibernate 自定义类型。 |
对话框左下方列出所选数据库中的表,并按类型和当前映射状态分组:
映射的关系 :已映射到实体的表。 未完全映射的项带有 未映射的列标签。
表 :未映射到任何实体的表。
选择表或关系时,对话框右下方会列出其可映射元素,并同样按状态分组:
映射的列 :已映射到实体特性的列。
列 :未映射到任何实体特性的列。
引用: 其他表中指向此表且未映射到此表实体中任何特性的外部密钥。
对于每个可映射项,对话框会显示以下选项:
条目 | 描述 |
|---|---|
类名 | 指定生成的实体类的名称。 IntelliJ IDEA 会根据表名称和 JPA 逆向工程设置自动填充此值。 |
ID 生成 | 选择主密钥的 ID 生成策略:
|
ID 列 | 选择哪些列应被视为主键列。 |
列/引用名 | 所选表中的列名称以及其他表中对其的引用,均为只读。 使用复选框选择要进行逆向工程的列和引用。 |
特性 | 为生成的实体字段指定名称。 IntelliJ IDEA 会根据列名称以及适用时的 JPA 逆向工程设置自动填充这些值。 |
映射类型 | 选择如何将列或引用映射到实体特性。 有关所有可用值的描述,请参阅 可用的映射类型。 |
特性类型 | 选择用于生成的实体字段的特性类型。 |
可用的映射类型
映射类型 下拉菜单列表可用于选择在逆向工程期间如何将列或引用映射到实体特性。 可用值取决于该项表示普通数据、数据库密钥还是来自另一个表的引用。
普通列
值 | 描述 | 编码示例 |
|---|---|---|
基本 | 将列映射到基本类型的字段。 |
@Column(name = "status", nullable = false, length = 20)
private String status;
|
枚举 | 将列映射到单独的枚举类,然后使用 |
Book.java
@Enumerated(EnumType.STRING)
@Column(name = "status", nullable = false, length = 20)
private StatusType status;
StatusType.java
public enum StatusType {
}
|
待办事项 | 将列映射到基本类型的字段,但用 将文本光标放在操作处并按 Ctrl+B ,即可从 |
/*
TODO [Reverse Engineering] create field to map the 'status' column
Available actions: Uncomment as is | Remove column mapping
@Column(name = "status", nullable = false, length = 20)
private java.lang.String status;
*/
|
主键
值 | 描述 | 编码示例 |
|---|---|---|
基本 | 将列映射到基本类型的字段,并使用 |
@Id
@Column(name = "isbn", nullable = false, length = 13)
private String isbn;
|
复合密钥
值 | 描述 | 编码示例 |
|---|---|---|
嵌入式 ID | 将列映射到单独的可嵌入类,然后使用 @EmbeddedId 注解引用它。 |
BookAuthor.java
@EmbeddedId
private BookAuthorId id;
BookAuthorId.java
@Embeddable
public class BookAuthorId implements Serializable {
@Serial
private static final long serialVersionUID = -8507207156423735624L;
@Column(name = "book_isbn", nullable = false, length = 13)
private String bookIsbn;
@Column(name = "author_id", nullable = false)
private Long authorId;
}
|
ID 类 | 将列映射到单独的类,然后使用 @IdClass 注解和 |
BookAuthor.java
@IdClass(BookAuthorId.class)
public class BookAuthor {
@Id
@Column(name = "book_isbn", nullable = false, length = 13)
private String bookIsbn;
@Id
@Column(name = "author_id", nullable = false)
private Long authorId;
}
BookAuthorId.java
public class BookAuthorId implements Serializable {
private String bookIsbn;
private Long authorId;
}
|
外键
值 | 描述 | 编码示例 |
|---|---|---|
基本 | 将列映射到基本类型的字段。 |
@Column(name = "publisher_id")
private Long publisher;
|
多对一 | 将列映射到带有 |
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "publisher_id")
private Publisher publisher;
|
一对一 | 将列映射到带有 |
@OneToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "publisher_id")
private Publisher publisher;
|
待办事项 | 将列映射到带有关系注解的引用字段,但用 将文本光标放在操作处并按 Ctrl+B ,即可从 |
/*
TODO [Reverse Engineering] create field to map the 'publisher_id' column
Available actions: Uncomment as is | Remove column mapping
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "publisher_id")
private Publisher publisher;
*/
|
其他表中的引用
值 | 描述 | 编码示例 |
|---|---|---|
多对多 | 将引用映射到设置,并使用 |
@ManyToMany
@JoinTable(name = "book_authors", joinColumns = {@JoinColumn(name = "book_isbn")}, inverseJoinColumns = {@JoinColumn(name = "author_id")})
private Set<Author> authors = new LinkedHashSet<>();
|
一对多 | 将引用映射到设置,并在 |
@OneToMany(mappedBy = "bookIsbn")
private Set<Review> reviews = new LinkedHashSet<>();
|
一对一 | 将引用映射到单个字段,并在 |
@OneToOne(mappedBy = "bookIsbn")
private Review reviews;
|
映射类型 下拉菜单列表可用于选择在逆向工程期间如何将列或引用映射到实体特性。 可用值取决于该项表示普通数据、数据库密钥还是来自另一个表的引用。
普通列
值 | 描述 | 编码示例 |
|---|---|---|
基本 | 将列映射到基本类型的字段。 |
private String status = "";
|
枚举 | 将列映射到单独的枚举类,然后引用它。 |
Book.java
@Nullable
private StatusType status;
StatusType.java
public enum StatusType {
}
|
待办事项 | 将列映射到基本类型的字段,但用 将文本光标放在操作处并按 Ctrl+B ,即可从 |
/*
TODO [Reverse Engineering] create field to map the 'status' column
Available actions: Uncomment as is | Remove column mapping
private java.lang.String status = "";
*/
|
主键
值 | 描述 | 编码示例 |
|---|---|---|
基本 | 将列映射到基本类型的字段,并使用 |
@Id
private String isbn = "";
|
复合密钥
值 | 描述 | 编码示例 |
|---|---|---|
嵌入式 ID | 将列映射到单独的可嵌入类,然后引用它。 |
BookAuthor.java
@Nullable
@Id
@Embedded.Nullable
private BookAuthorId id;
BookAuthorId.java
@NullMarked
public class BookAuthorId {
private String bookIsbn = "";
private Long authorId = 0L;
}
|
外键
值 | 描述 | 编码示例 |
|---|---|---|
基本 | 将列映射到基本类型的字段。 |
@Nullable
@Column("publisher_id")
private Long publisher;
|
参考 | 将列映射到 AggregateReference 字段。 |
@Nullable
@Column("publisher_id")
private AggregateReference<Publisher, Long> publisher;
|
待办事项 | 将该列映射到 将文本光标放在操作处并按 Ctrl+B ,即可从 |
/*
TODO [Reverse Engineering] create field to map the 'publisher_id' column
Available actions: Uncomment as is | Remove column mapping
@Nullable
@Column("publisher_id")
private AggregateReference<Publisher, Long> publisher;
*/
|
其他表中的引用
值 | 描述 | 编码示例 |
|---|---|---|
设置 | 将该引用映射到设置,并在 @MappedCollection 注解中指向其外部密钥列。 |
@Nullable
@MappedCollection(idColumn = "book_isbn")
private Set<Review> reviews;
|
单引号 | 将该引用映射到单个字段,并在 @MappedCollection 注解中指向其外键列。 |
@Nullable
@MappedCollection(idColumn = "book_isbn")
private Review reviews;
|
参考:JPA 逆向工程设置
JPA 逆向工程 设置允许配置 IntelliJ IDEA 在逆向工程期间如何将数据库表和列映射为实体及实体字段。
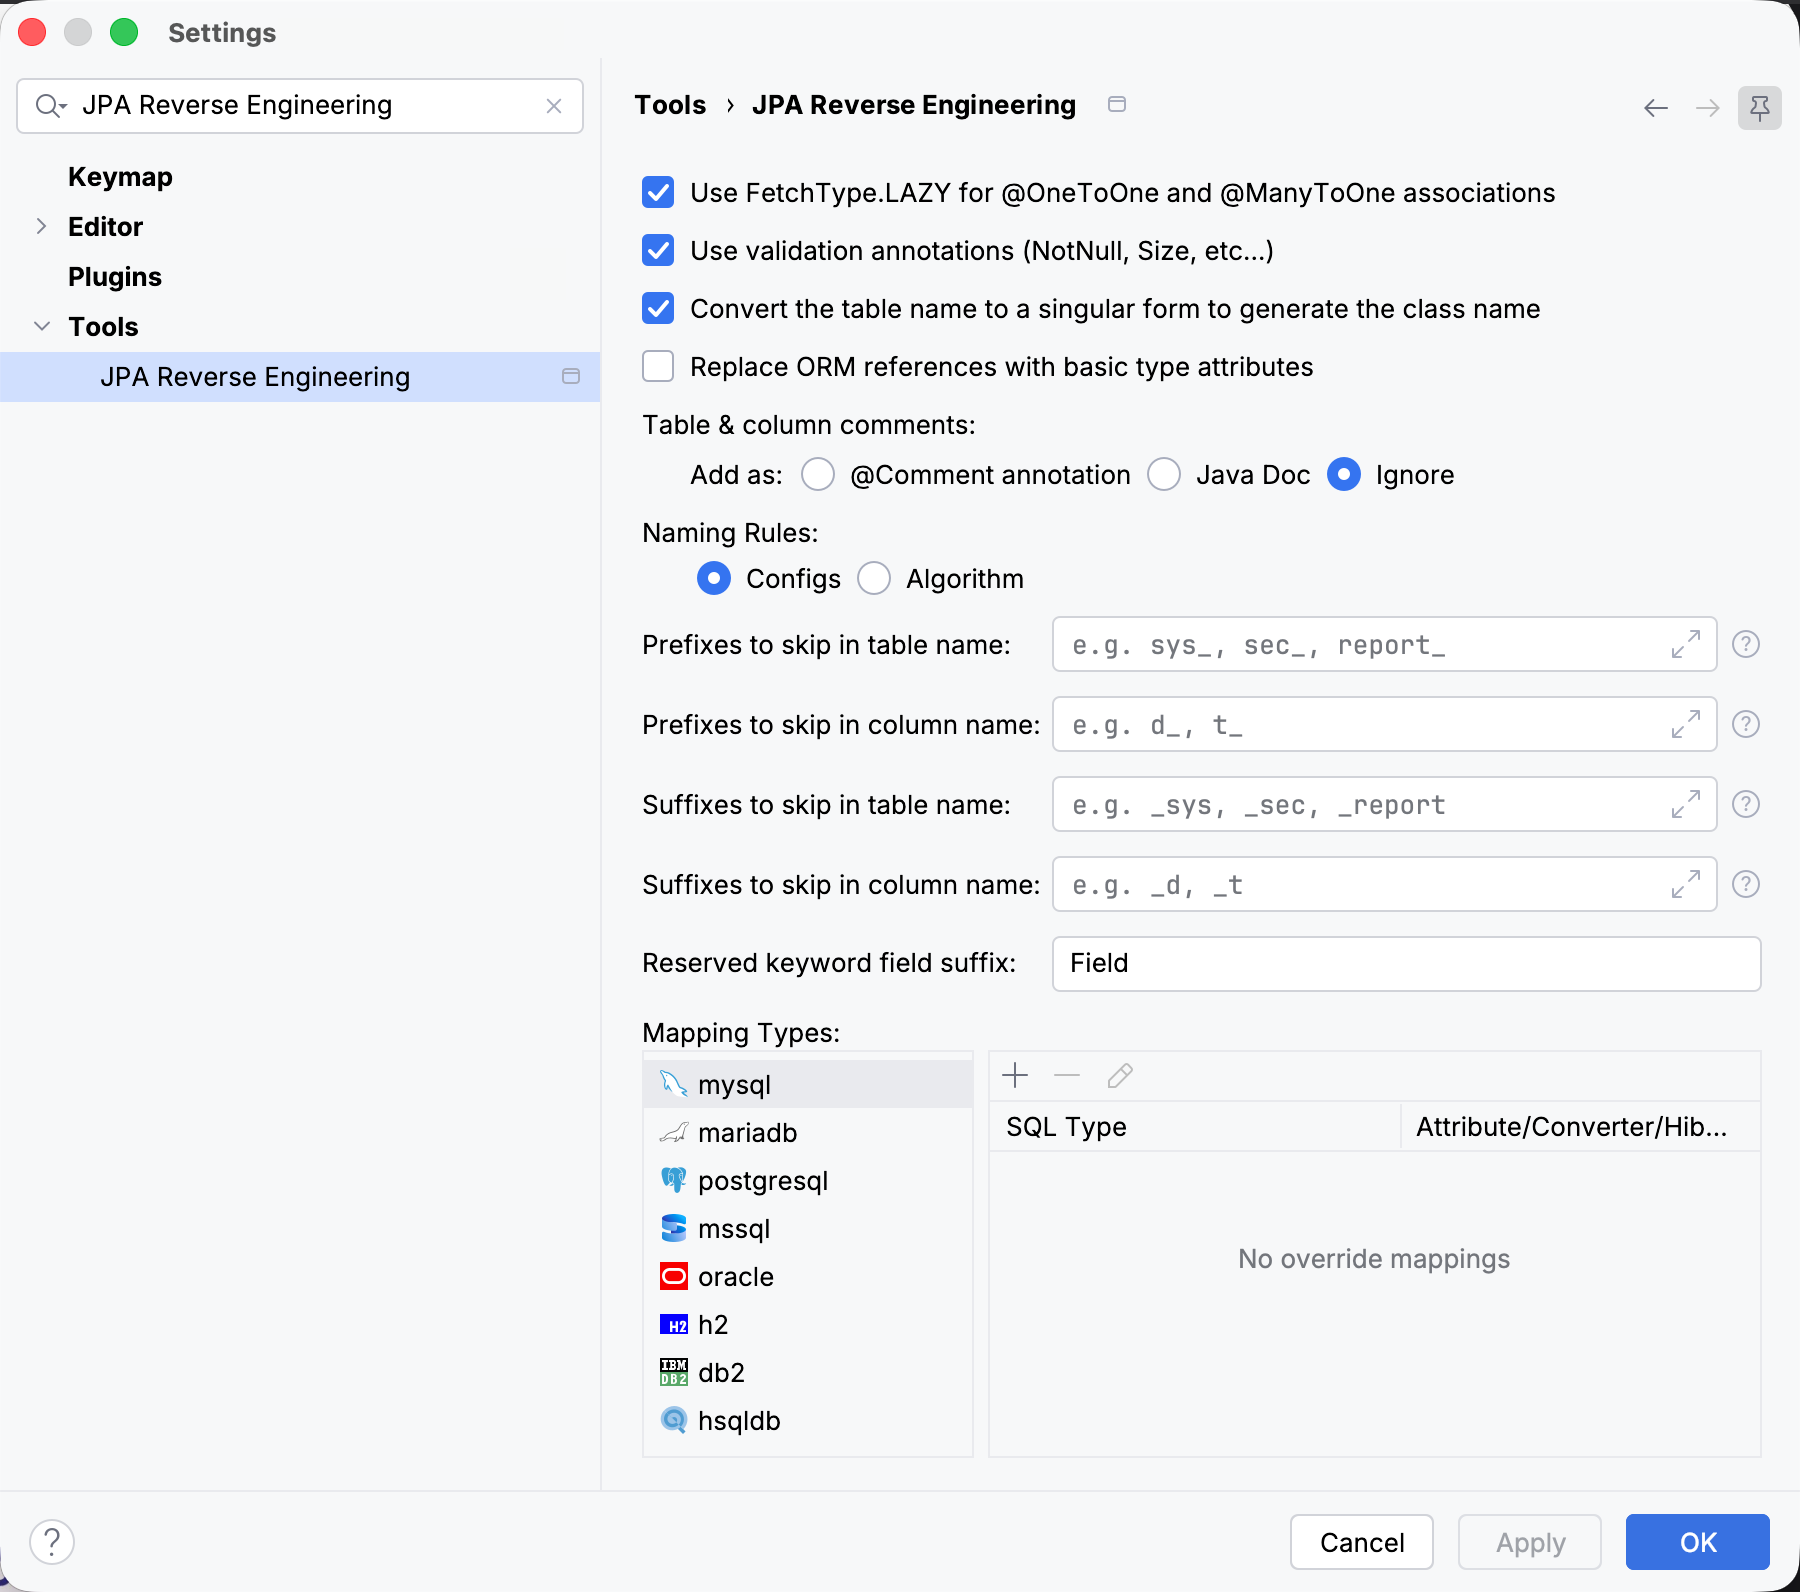
基础设置
条目 | 描述 |
|---|---|
为 @OneToOne 和 @ManyToOne 关联使用 FetchType.LAZY | 将 获取策略 设置为 |
使用验证注解(NotNull、Size 等…) | 使用根据列元数据推断的 Jakarta Bean Validation 约束 (如 |
将表名转换为单数形式以生成类名 | 为实体类命名时,将复数表名称转换为单数形式。 例如,如果表名称为 |
将 ORM 引用替换为基本类型特性 | 将外键列映射为基础特性,而不是关系字段。 例如,对于名称为 |
表和列评论。
表和列评论。 设置允许您选择如何处理表和列的注释:
@Comment 注解 :将其插入 Hibernate
@注释注解中。Java 文档 :将其插入 Javadoc 注释。
忽略 :完全不要插入到编码中。
命名规则
命名规则 设置允许您配置如何将表和列名转换为实体类和字段的名称。 当数据库遵循特定命名约定并且不希望其延续到生成的编码时(如前缀或后缀),此设置非常有用。
您可以选择以下策略之一:
配置 :配置与前缀和后缀相关的设置:
条目 | 描述 |
|---|---|
表名中要跳过的前缀 | 指定在为实体类命名时应从表名称中去除哪些前缀。 例如,若在该字段中输入 如需输入多个值,用逗号分隔。 |
列名中要跳过的前缀 | 指定在为实体字段命名时应从列名称中去除哪些前缀。 如需输入多个值,用逗号分隔。 |
表名中要跳过的后缀 | 指定在为实体类命名时应从表名称中去除哪些后缀。 如需输入多个值,用逗号分隔。 |
列名中要跳过的后缀 | 指定在为实体字段命名时应从列名称中去除哪些后缀。 如需输入多个值,用逗号分隔。 |
保留关键字字段后缀 | 如遇与 保留 Java 关键字 冲突时,请指定应添加到实体字段名称的后缀。 例如,如果将该后缀设置为 |
算法 :用 Java 编写自定义命名逻辑。 选择此选项后,会显示代码编辑器。 其中包含可根据数据库命名约定调整的方法存根。
映射类型
映射类型 设置允许您重写默认的 SQL 到 Java 类型映射。 可根据需要将 SQL 类型映射为 Java 特性类型、JPA 特性转换器或 Hibernate 自定义类型。 当应用程序需处理特定数据库类型、加密数据或支持使用不同 SQL 类型的多种数据库管理系统时,此设置十分有用。
可为以下数据库管理系统重写类型映射:
下方视频演示如何重写类型映射并使用 Hibernate @JavaType 注解: