检测并修复数据问题
IntelliJ IDEA 可以自动分析加载到 pandas 数据帧中并显示在 Jupyter Notebook 单元格中的数据集。 IDE 会高亮显示潜在问题,例如缺失值、异常值、重复行、重复的列名称或常量列,从而便于在建模前清理数据。
IntelliJ IDEA 会自动分析满足以下条件的任何数据帧:
包含不超过 100,000 行。
包含不超过 200 列。
使用
df、df.head()、df[x:y]、df.loc(.. .)或df.iloc(...)显示。
如果至少发现一个问题,DataFrame 工具栏上会出现  数据集问题 按钮。
使用 AI 修复数据问题
在 DataFrame 工具栏中点击
数据集问题 按钮。 数据集质量问题 对话框将打开。
选择要修复的问题,然后点击 使用 AI 修正 按钮。
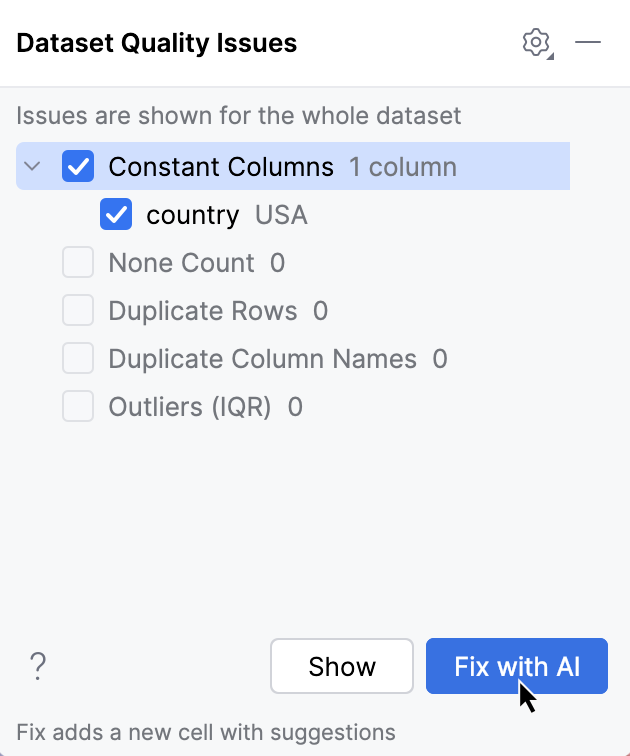
将在 DataFrame 下方创建一个新的代码单元格,其中包含建议的更改。
常见问题及其处理方法
缺失值
数据集中的某些单元格可能没有值,表示为 NaN 或 无。 这通常发生在数据收集、合并或文件导入期间。 如果忽略,缺失值可能会为您的分析引入偏差。 某些机器学习算法也无法在包含缺失值的数据上运行。
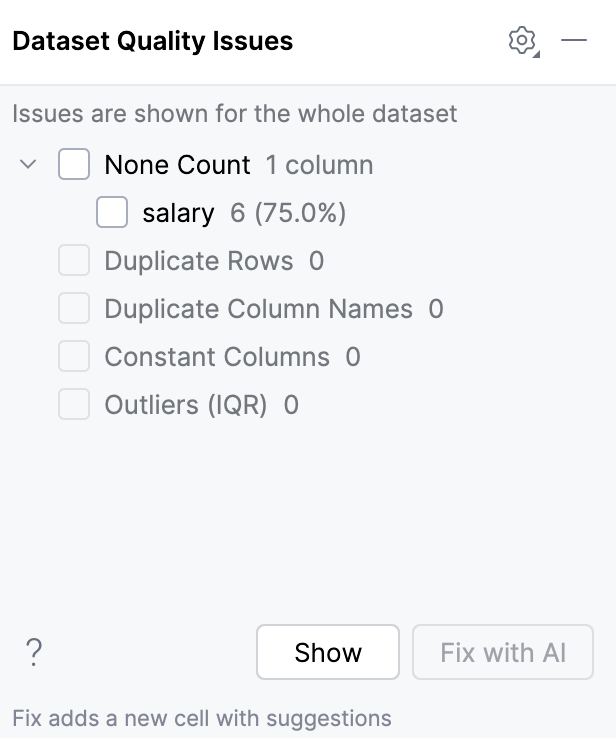
例如,在 salary 列中发现了 6 个空单元格:
处理此问题的典型修复包括:
删除含有过多未知值的行或列:
df = df.dropna()将未知值替换为常量,例如
0或未知:df['Name'] = df['Name'].fillna('Unknown')将未知值替换为该列的均值、中位数或众数:
df = df.fillna(df.mean())使用机器学习模型(例如 线性回归 或 k 最近邻)预测并替换缺失值:
from sklearn.impute import KNNImputer imputer = KNNImputer(n_neighbors=5) df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)
重复的列名称
数据集可能包含多个具有相同名称的列,例如在手动分配列名称或合并数据集之后。 重复的列名称可能会使列选择变得不明确,并可能在数据处理期间导致意外结果。
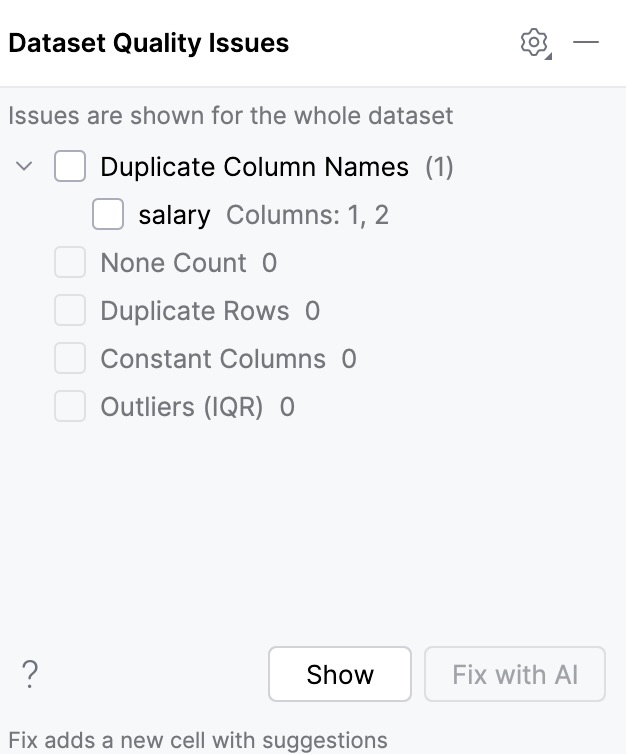
例如,在数据集中发现了两个名称重复的列:
处理此问题的典型修复包括:
重命名重复列
如果重复列包含冗余数据,则将其移除:
df = df.loc[:, ~df.columns.duplicated()]
重复行
数据集中的某些行可能完全相同,例如由于重复导入或日志记录错误导致。 如果忽略,可能会引入偏差并使统计结果不可靠。
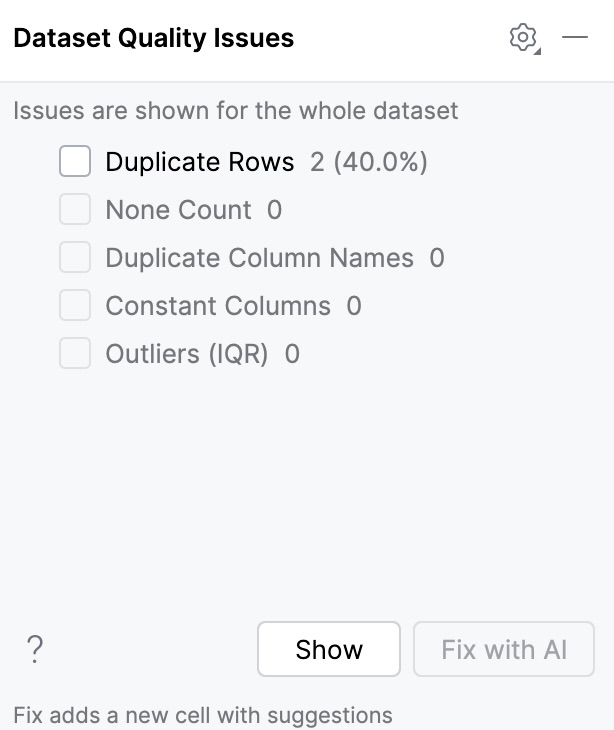
例如,在数据集中发现了 2 行重复数据:
处理此问题的典型修复包括:
删除所有重复行:
df = df.drop_duplicates()删除除第一次出现之外的所有重复项:
df = df.drop_duplicates(keep='first')
异常值
异常值是与数据集中大多数其他值显著不同的数据点。 它们可能会扭曲统计结果并影响机器学习模型。
PyCharm 使用四分位距 (IQR) 方法检测异常值。 如果某个值低于 Q1 - 1.5 × IQR 或高于 Q3 + 1.5 × IQR ,则会被视为异常值,其中 Q1 和 Q3 分别为第一四分位数和第三四分位数。
通常建议仅在您认为它们属于与您试图针对的总体不同的总体时才删除异常值。 详细信息请参阅 本文。
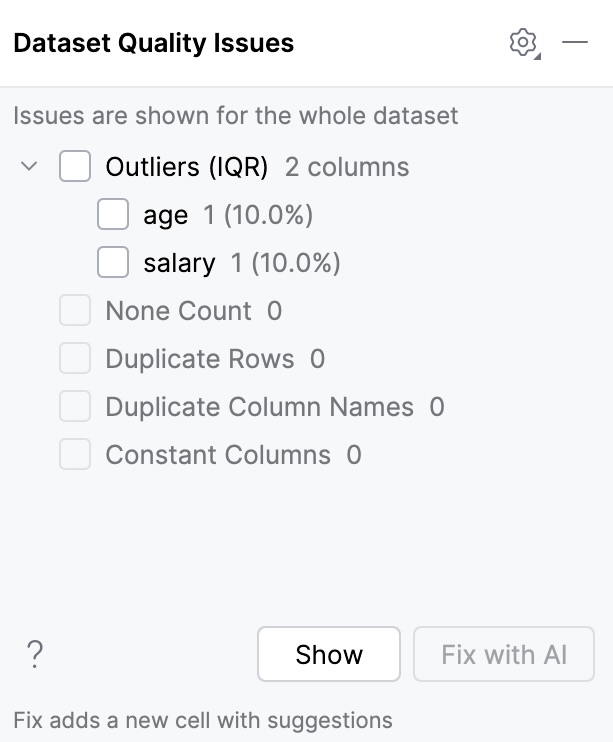
例如,在 salary 和 age 列中发现了异常值:
处理此问题的典型修复包括:
使用统计方法(例如 IQR)发现极端值:
Q1 = df["salary"].quantile(0.25) Q3 = df["salary"].quantile(0.75) IQR = Q3 - Q1 outliers = df[ (df["salary"] < Q1 - 1.5 * IQR) | (df["salary"] > Q3 + 1.5 * IQR) ]删除具有极端值的行:
df = df[df['salary'] < 20000]将极端值截断到某个阈值:
df['salary'] = np.where(df['salary'] > 20000, 20000, df['salary'])转换数值以降低异常值的影响(例如应用对数变换):
df['salary_log'] = np.log1p(df['salary'])
常量列
数据集中的某些列在所有行中可能都包含相同的值。 此类常量列通常不会为分析或模型添加任何有用信息,因为它们没有可变性。
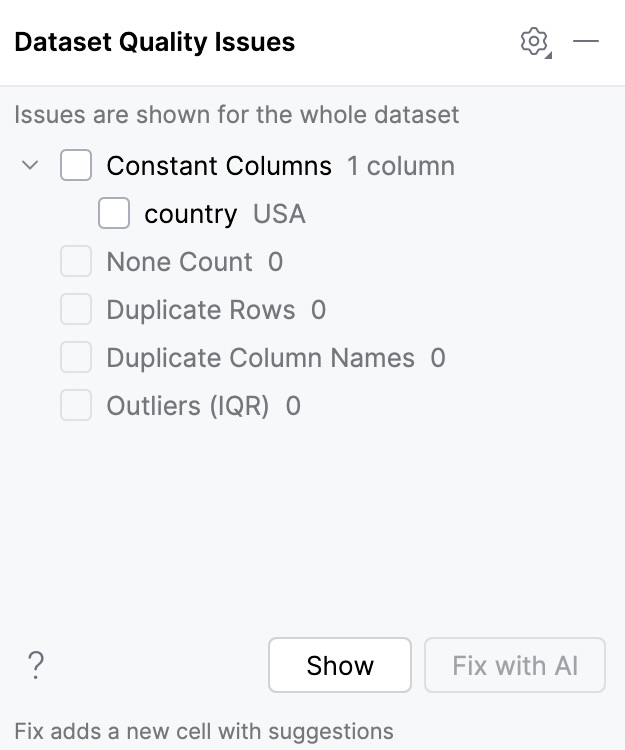
例如,发现了列 country ,其常量值为 USA:
处理此问题的典型修复方法是:
删除所有单值列:
df = df.drop(columns=single_value_cols)