模型上下文协议(MCP)
AI Assistant 可以通过 模型上下文协议(MCP) 与外部工具和数据源交互。 连接到 MCP 服务器后,AI Assistant 可访问一系列极大扩展其功能的工具。
- 支持的传输机制
AI Assistant 支持以下用于连接到 MCP 服务器的 传输机制:
标准输入/输出(STDIO) – AI Assistant 作为子进程启动 MCP 服务器,并通过标准输入和输出交换数据。 此传输通常用于本地 MCP 服务器。
可流式 HTTP – AI Assistant 通过 HTTP 使用模型上下文协议规范中定义的可流式 HTTP 传输机制连接到 MCP 服务器。 此传输机制允许通过单个 HTTP 端点与本地或远程 MCP 服务器进行通信,并支持请求/响应和流式交互。
- 获取 MCP 服务器的位置
根据您的用例和设置,已有许多兼容 MCP 的服务器可供使用。 作为起点,您可以浏览 官方 MCP 仓库中提供的参考服务器,其中包括示例、使用说明和配置信息。
- 连接 MCP 服务器所需的内容
要将 AI Assistant 连接到 MCP 服务器,您需要一个 JSON 配置,其中定义了用于启动服务器的命令和参数。 确切的配置取决于具体的 MCP 服务器。 在大多数情况下,服务器开发者会提供可获取并使用的推荐配置。
连接到 MCP 服务器
连接到 MCP 服务器:
转到 。
或者,您可以在聊天中输入
/并选择 添加命令 选项,以打开带有 MCP 设置的界面。
在 模型上下文协议(MCP) 设置页面上,点击
 添加 以添加新的 MCP 服务器配置。
在 新建 MCP 服务器 对话框中,选择要如何连接到 MCP 服务器,并提供 JSON 配置:

JSON 配置—— 提供包含启动 MCP 服务器所需参数的 JSON 代码段。 配置需遵循以下格式:
{ "mcpServers": { "yourServerName": { "command": "path-or-command-to-start-server", "args": [ "optional-arguments-passed-to-server" ] } } }工作目录—— 指定启动服务器的文件夹路径。 这使您可以在参数中使用相对路径,而无需使用绝对路径。
服务器级别 – 指定配置的服务器应全局可用,还是仅在当前项目中可用。

JSON 配置—— 提供包含启动 MCP 服务器所需参数的 JSON 代码段。 配置需遵循以下格式:
{ "mcpServers": { "yourServerName": { "url": "https://example.com/mcp" } } }服务器级别 – 指定配置的服务器应全局可用,还是仅在当前项目中可用。
点击 确定。 MCP 服务器将出现在列表中。
点击 Apply。 这将启动已配置的服务器并建立连接。 您可以在 状态 列中监控连接的状态。
由 MCP 服务器提供的工具将可供 AI Assistant 使用。 处理请求时,系统将自动触发这些功能,或者您也可以在聊天中手动输入适当的 / 命令来调用它们:

查看可用工具
连接 MCP 服务器成功建立后,您可以点击 状态 列中的图标,查看可用工具列表。

更改服务器级别
如果需要更改 MCP 服务器的可用级别,请点击  按钮,在 级别 列中,并选择该设置是全局可用还是仅在当前项目中可用。

停止 MCP 服务器
要停止 MCP 服务器:
取消选中您要停止的 MCP 服务器对应的复选框。

点击 Apply。
重新连接到 MCP 服务器
要重新连接到 MCP 服务器:
请选择您想要重新连接的服务器。
点击
 重新连接 按钮。
获取 MCP 服务器日志
为调试目的,您可能需要查看已启动的 MCP 服务器日志。要执行此操作: 为此:
在主菜单中,转到 并在 Windows 上选择 在资源管理器中显示日志 ,或在 macOS 上选择 在 Finder 中显示日志。 这将打开日志目录。
找到 mcp 文件夹并打开它。 该文件夹包含每个已配置 MCP 服务器的日志。
JSON 配置示例
本节提供将 AI Assistant 连接到 MCP 服务器的配置示例,具体取决于服务器的托管方式。 涵盖本地安装服务器、基于 NPX 的设置、基于 Docker 的环境和远程服务器。
- 本地安装
如果 MCP 服务器安装在您的本机上,您可以通过运行服务器可执行文件并附加所需参数来连接。 此类配置的模板如下所示:
{ "mcpServers": { "yourServerName": { "command": "command-to-run-server", "args": [ "path-to-server-executable-or-script", "optional-arguments-for-server" ] } } }command是启动 MCP 服务器的可执行文件或脚本。 这可以是node、指向可执行文件的直接路径,或用于启动服务器的其他命令。args列表包含在启动服务器时传递的参数,如服务器脚本路径或配置选项。
例如,如果您使用 Filesystem MCP server ,则配置可能如下所示:
{ "mcpServers": { "filesystem": { "command": "node", "args": [ "/Users/JohnDoe/IdeaProjects/servers/src/filesystem/dist/index.js", "/Users/JohnDoe/Desktop" ] } } }此处,
node命令用于运行服务器脚本。 第一个实参指定服务器脚本的路径,第二个实参指定允许服务器操作的目录。- 使用 NPX
如果未在本地安装 MCP 服务器,您可以使用
npx按需下载并运行它。 此类配置的模板如下所示:{ "mcpServers": { "yourServerName": { "command": "npx", "args": [ "-y", "npm-package-name", "optional-arguments-for-server" ] } } }command被设置为npx,用于从 npm registry 运行一个软件包,而无需全局安装。args列表包含:-y—— 用于在首次运行软件包时自动确认可能出现的提示,提供 MCP 服务器的软件包名称,
传递给服务器的其他实参,例如文件路径或配置选项。
例如,如果您使用 Filesystem MCP server ,则配置可能如下所示:
{ "mcpServers": { "filesystem": { "command": "npx", "args": [ "-y", "@modelcontextprotocol/server-filesystem", "/Users/JohnDoe/Desktop" ] } } }此处,
npx命令运行@modelcontextprotocol/server-filesystem软件包。 实参中提供的路径指定了允许服务器操作的目录。- 使用 Docker
您可以使用 Docker 在隔离环境中运行 MCP 服务器。 这将在容器内启动服务器,并将本地文件夹挂载到容器中,以便服务器能够访问它们。 此类配置的模板如下所示:
{ "mcpServers": { "yourServerName": { "command": "docker", "args": [ "run", "-i", "--rm", "--mount", "type=bind,src=/local/path,dst=/container/path", "docker-image-name", "/container/path" ] } } }command设置为docker,将在基于指定 Docker 镜像的容器中启动 MCP 服务器。args列表包含:运行—— 用于启动新容器,-i—— 用于保持容器为交互式,使 IDE 可与之通信,--rm—— 用于在使用后自动移除容器,一个或多个
--mount选项 —— 用于将本地文件夹(src)绑定到容器路径(dst),提供 MCP 服务器的 Docker 镜像名称,
用于告诉服务器容器内允许操作的目录的最终实参。
例如,如果您使用 Filesystem MCP server ,则配置可能如下所示:
{ "mcpServers": { "filesystem": { "command": "docker", "args": [ "run", "-i", "--rm", "--mount", "type=bind,src=/Users/JohnDoe/Desktop,dst=/projects/Desktop", "--mount", "type=bind,src=/Users/JohnDoe/Documents,dst=/projects/Documents,ro", "mcp/filesystem", "/projects" ] } } }此处,
docker命令运行mcp/filesystem镜像。 本地文件夹 /Users/JohnDoe/Desktop 和 /Users/JohnDoe/Documents 被挂载到容器中, /项目 实参告诉服务器在容器内的操作位置。- 远程服务器
如果 MCP 服务器托管在远程且可通过 HTTP 访问,您可以通过在配置中指定其 URL 进行连接。 此类配置的模板如下所示:
{ "mcpServers": { "yourServerName": { "url": "http://remote-server-address/mcp" } } }url参数表示 MCP 服务器的 HTTP 端点。 这应指向为服务器实现可流式 HTTP 传输的基础 URL。
例如,要连接到远程 MCP 服务器,您的配置可能如下:
{ "mcpServers": { "microsoftdocs": { "url": "https://learn.microsoft.com/api/mcp" } } }此时,AI Assistant 通过 HTTP 使用可流式 HTTP 传输机制连接到 MCP 服务器。 服务器由远程管理,AI Assistant 通过指定的 URL 直接与其通信。
将您的 IDE 用作 MCP 服务器
从版本 2025.2 开始,JetBrains IDE 内置了集成的 MCP Server ,允许 Claude Code、Codex、VS Code 等外部客户端访问 IDE 提供的工具。 这样,用户无需离开自己选择的应用程序,就能控制 JetBrains IDE 并与其交互。
启用 MCP 服务器插件
此功能依赖于 MCP 服务器插件,该插件在 JetBrains IDE 中默认捆绑并启用。 如果相关功能不可用,请确保您未禁用该插件。
按 Ctrl+Alt+S 打开设置,然后选择 。
找到 MCP Server 插件并点击 启用。
启用 MCP Server
要启用 MCP 服务器,请执行以下操作:
转到 。
请选择 启用 MCP Server 复选框。
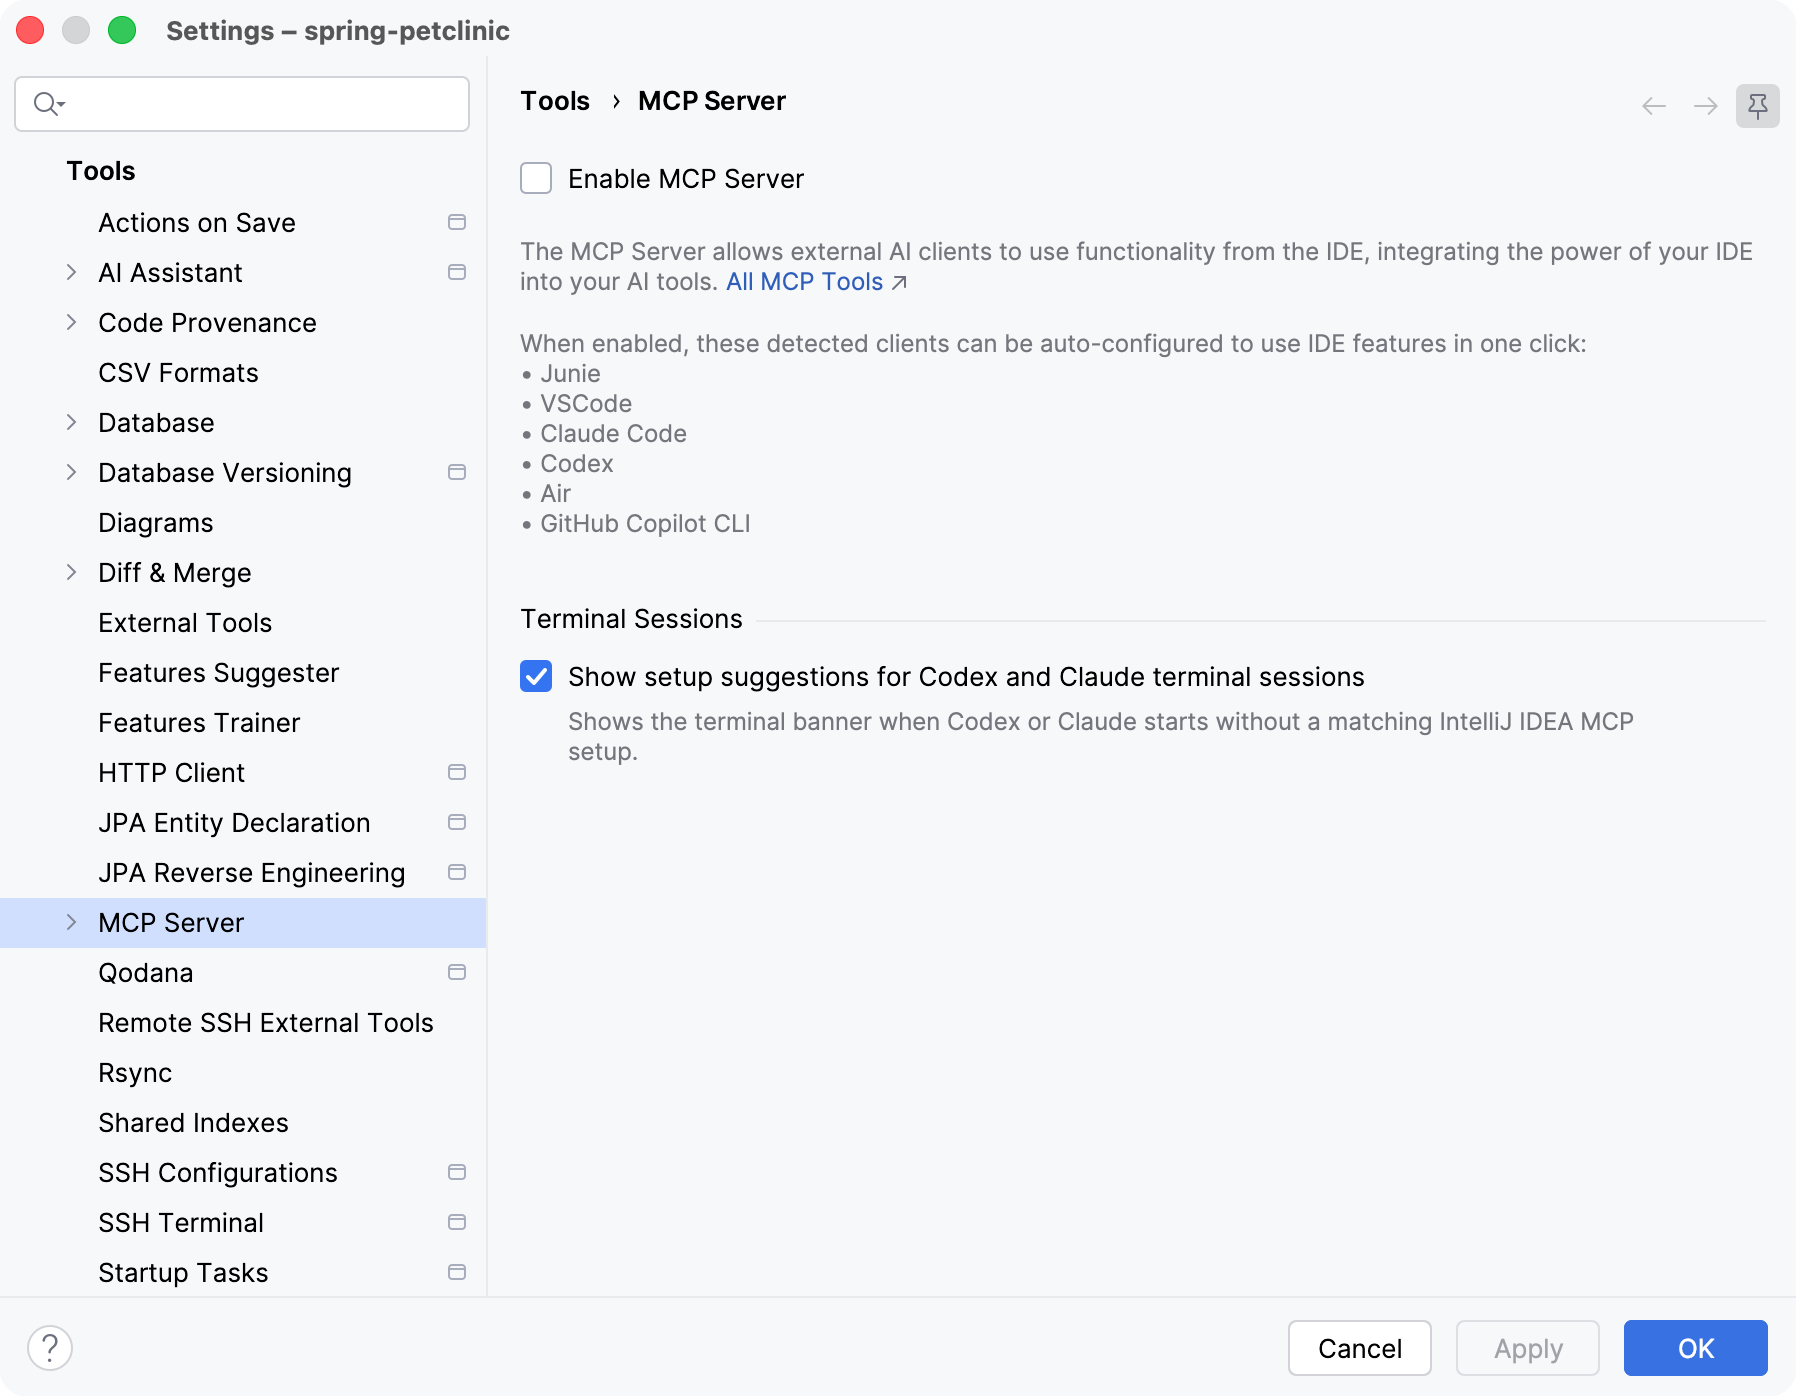
在 启用 MCP 服务器? 对话框中,查看第三方应用程序将获得对 IDE 中打开项目的哪些访问权限,然后点击 启用 继续。
点击 Apply。
启用 MCP 服务器后,可以继续配置外部客户端。
外部客户端设置
对于检测到的外部客户端,例如 Junie、 VS Code、 Claude Code、 Codex、 Air 和 GitHub Copilot CLI ,可以自动执行配置。 设置客户端意味着将 IDE MCP 服务器的地址添加到该客户端的配置文件中。
为此:
转到 。
在 客户端自动配置 部分,为每个要与 MCP 服务器一起使用的客户端点击 自动配置。 这会自动更新客户端的配置文件。 已配置传输的集合取决于客户端。
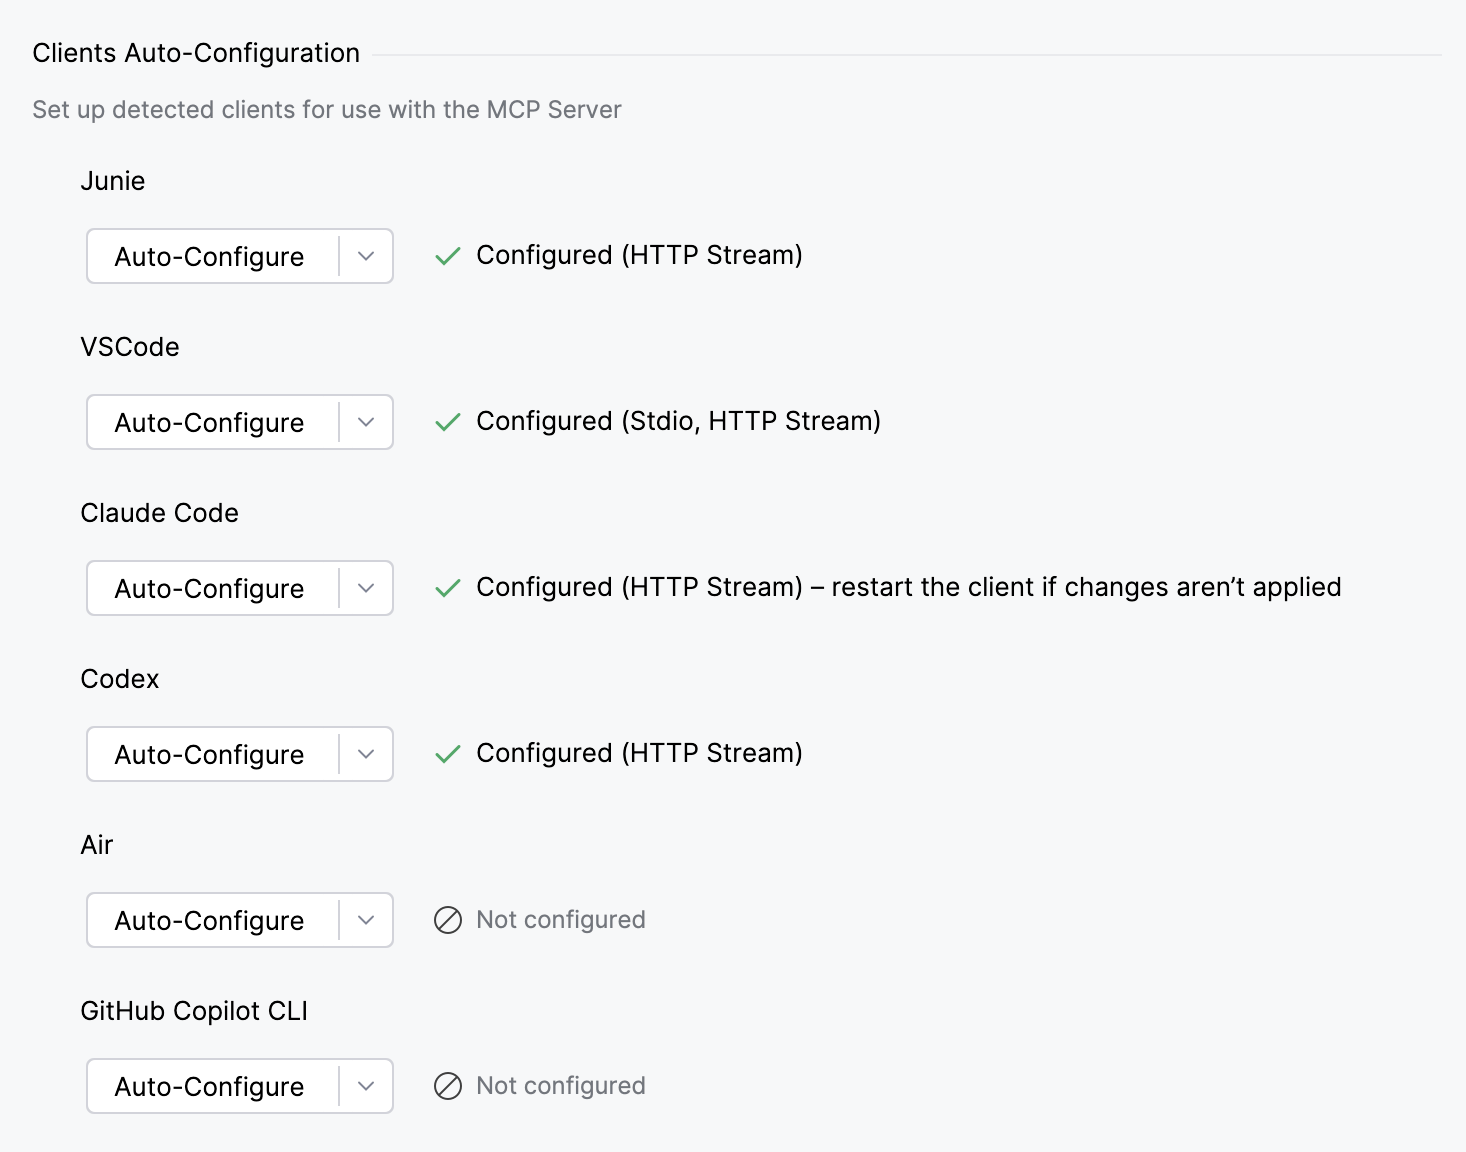
要自行配置特定传输,请点击
(位于 自动配置 旁边),然后从列表中选择所需选项。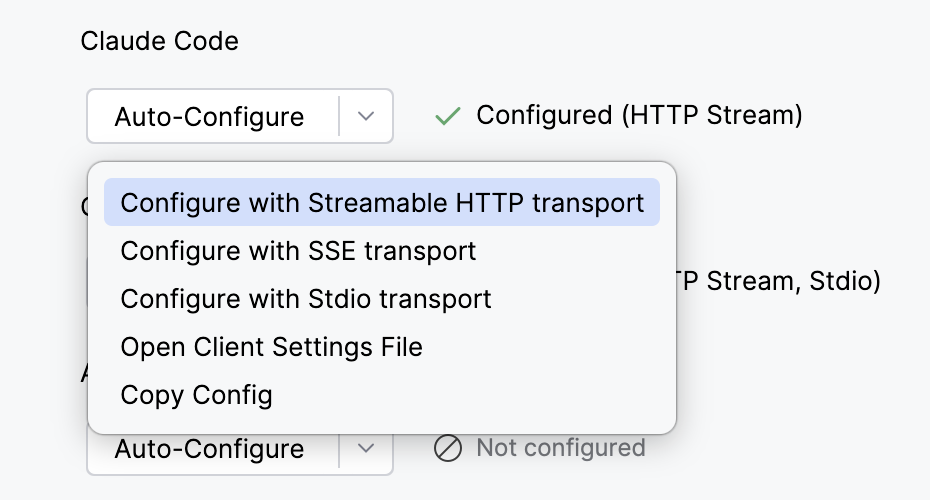
重启客户端以使配置生效。
项目级客户端设置
某些客户端还会从项目的工作目录读取配置文件。 对于这些客户端,IDE 可以将连接设置直接写入当前打开项目中的配置文件,因此 MCP 服务器仅在处理该项目时可用。
如果处理多个项目,并且不希望为每个客户端会话注册 MCP 服务器,请使用此选项。
转到 。
在 项目客户端自动配置 部分中,为每个要设置的客户端点击 自动配置。 这会自动更新客户端的项目级配置文件。
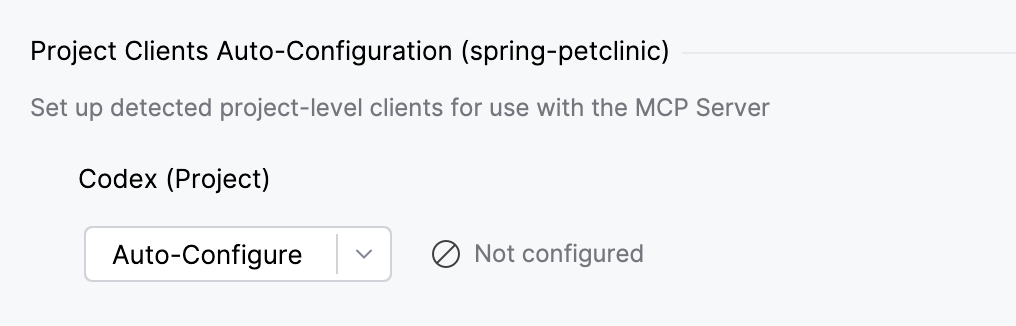
如果要配置特定传输机制,请点击
(位于 自动配置 旁边),然后从列表中选择所需选项。重启客户端以使配置生效。
手动客户端设置
如果要连接的客户端不在列表中,请手动配置。
在 手动配置客户端 部分,根据连接类型点击 复制 SSE 配置、 复制 Stdio 配置 或 复制 HTTP 流配置。
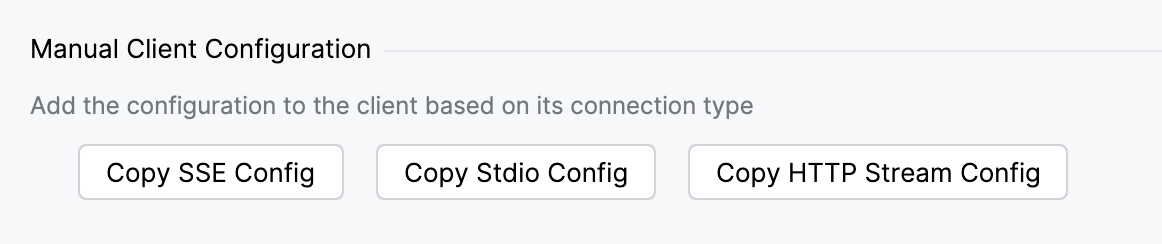
将复制的配置粘贴到您的客户端的设置或配置文件中。
重启客户端以使配置生效。
无需确认执行操作
MCP 服务器允许已连接的外部客户端在 IDE 中执行终端命令或运行配置,而无需每次都提示用户确认。
要启用此模式:
转到 。
在 命令执行 部分,启用 在无需确认的情况下运行 Shell 命令或运行配置(勇敢模式) 设置。
点击 Apply。
在终端会话中显示设置建议
当 Codex 或 Claude 在终端会话中启动且没有匹配的 MCP 服务器设置时,IDE 可以显示一条横幅,建议配置连接。
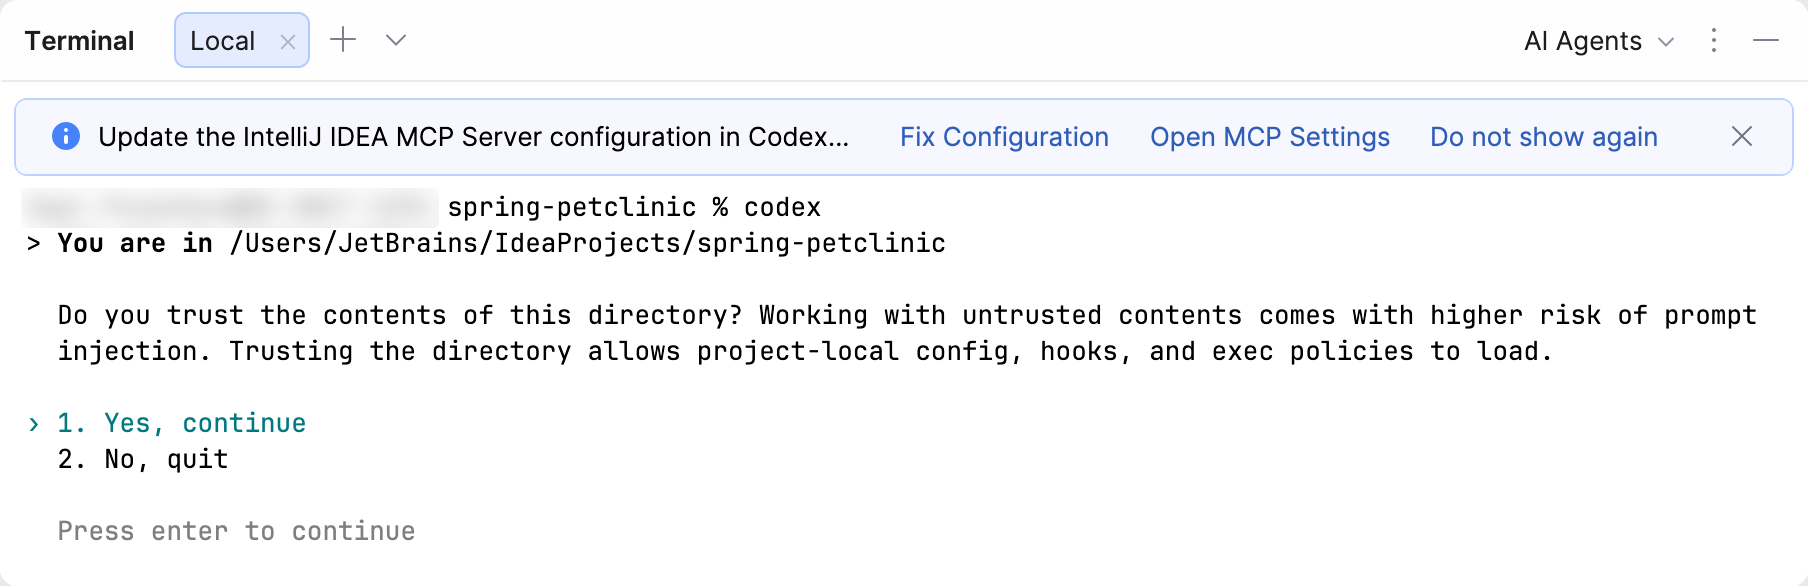
要控制此行为:
转到 。
在 终端会话 部分中,选中或清除 显示 Codex 和 Claude 终端会话的设置建议 复选框。
点击 Apply。
支持的工具
MCP 服务器提供了一组工具,允许外部客户端与 IDE 和项目交互,例如分析代码、修改文件、运行配置或执行终端命令。
可在 中查看和管理全部可用工具列表。 对于每个工具,选中或清除 已启用 复选框,以控制该工具是否暴露给外部客户端。
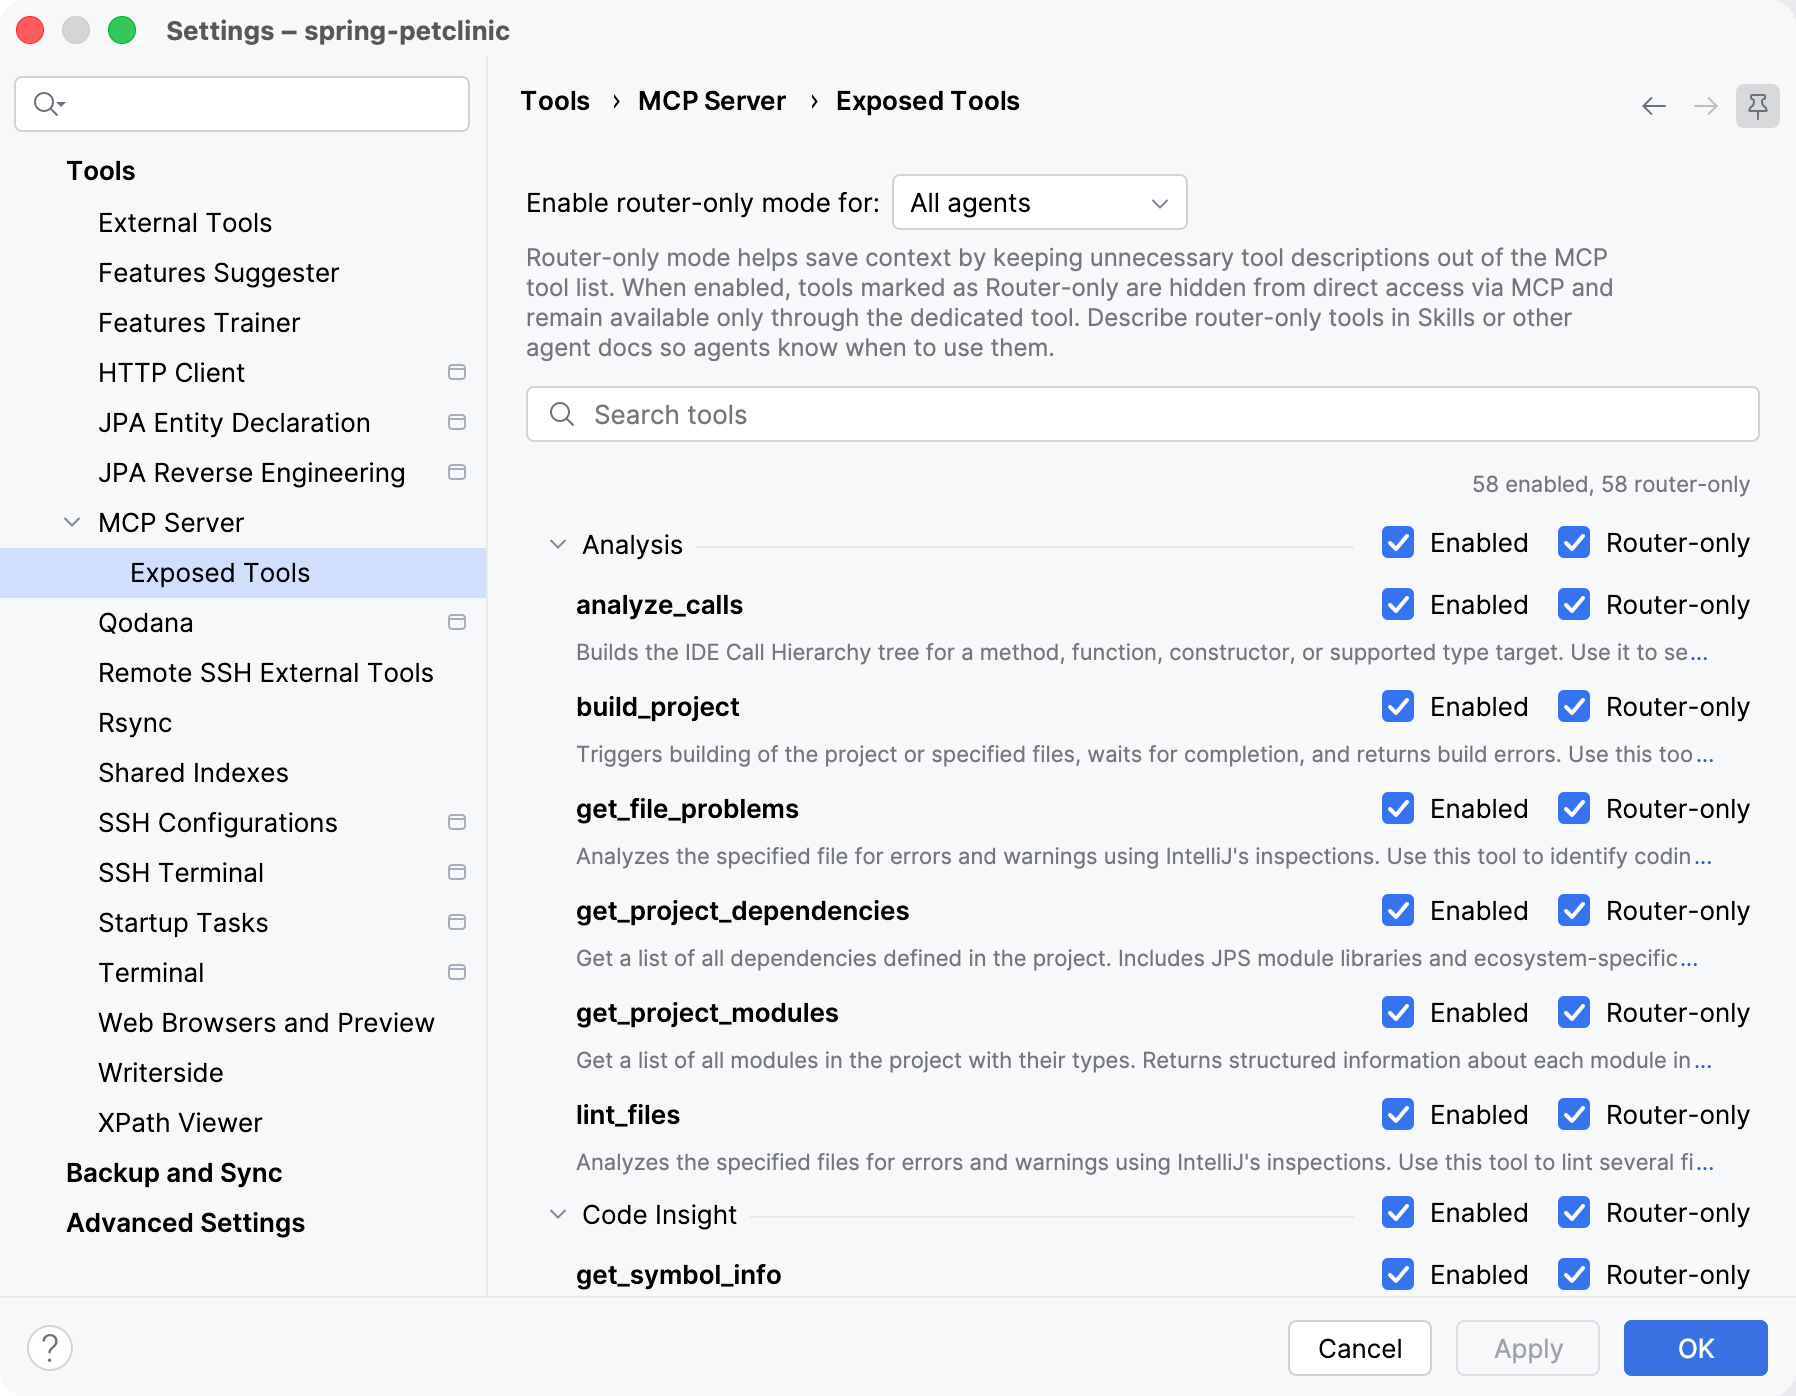
也可以为工具选中 仅路由器 复选框。 仅路由器工具会从直接 MCP 工具列表中隐藏,并且只能通过专用路由器 工具使用。 这样可以避免工具列表中出现不必要的工具描述,并节省上下文。 使用 为以下对象启用仅路由器模式 设置来指定仅路由器模式适用的时间,例如针对 所有智能体 或 仅限 ACP 智能体。
下方可找到由 MCP 服务器提供的工具列表。
分析工具
- analyze_calls
为方法、函数、构造函数或受支持的类型目标构建 IDE 调用层次结构树。 使用它可以查看谁调用了符号(
INCOMING_CALLS),或该符号调用了什么(OUTGOING_CALLS)。按实际调用评估依赖项时,优先使用此工具,而不是用法搜索、文本搜索或正则表达式搜索。 它使用 IDE 调用层次结构数据,因此相比基本搜索,可以提供更精确的调用关系,噪音更少,后续调用也更少。
将
symbolFqn作为完全限定名称传递,例如com.example.Service.run。 如果名称有歧义,该工具会返回确切签名;请将其中一个作为symbolFqn传回。 如果只知道短名称或片段,请先使用搜索符号查找目标。结果是一个可展开的文本树。 每个节点都包含
filePath和treePath;filePath在可能的情况下相对于项目。 传回treePath以渲染子树。 使用childOffset在截断的 … 之后继续 以及另外 n 个 行。depth、maxChildren和maxNodes会限制渲染的树。 当 IDE 可以解析符号时,符号可能来自项目源代码、源 jar 或反编译的二进制 jar 依赖项。参数:
symbolFqn(必填):普通的完全限定符号名称,或由歧义错误返回或从渲染的子节点复制的确切签名。 如果只知道短名称或片段,请先使用搜索符号,并在此处传递最合适的完全限定可调用名称。 示例:com.example.Service.run、com.example.Service.run(String)或org.assertj.core.api.Assertions.assertThat(String)。 不要传递文件路径、行、列或单独的目标签名。analysisKind(必填):调用分析方向。 使用INCOMING_CALLS显示symbolFqn的调用方,或使用OUTGOING_CALLS显示从symbolFqn调用的符号。depth:在请求的子树根下渲染的最大调用级别数。 默认值为 5。 使用 0 仅渲染子树根。maxChildren:为每个节点渲染的直接子节点最大数量。 默认值为 50。maxNodes:渲染的调用节点总数上限。 默认值为 1000。treePath:子树根的可选路径,从之前的analyze_calls结果中逐字复制。 Null 或省略表示根路径[]。 每个组件都是确切签名,而不是显示名称。childOffset:对treePath所定位节点的直接子节点进行分页的偏移量。 默认值为 0。timeout:超时(毫秒)。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 构建项目名称
触发项目或指定文件的构建,等待完成,并返回构建错误。 可用此工具构建项目或编译文件,并获得编译错误和警告的详细信息。
编辑后需使用此工具以校验编辑是否合法。
参数:
rebuild:是否执行项目的完整重建。 默认值为 false。 仅在未指定filesToRebuild时生效。filesToRebuild:如已指定,仅编译指定路径下的文件。 路径相对于项目根目录。timeout:超时(毫秒)。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_file_problems
使用 IntelliJ 检查分析指定文件中的错误和警告。 使用此工具识别特定文件中的代码问题、语法错误及其他问题。
返回问题列表,包括严重性、描述和位置信息。
参数:
filePath:相对于项目根目录的路径。errorsOnly:是否仅包含错误,或同时包含错误和警告。timeout:超时(毫秒)。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_project_dependencies
返回项目中定义的所有依赖项列表。 提供有关库名称的结构化信息。
参数:
projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_project_modules
返回项目中所有模块及其类型的列表。 提供每个模块的结构化信息,包括其名称和类型。
参数:
projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- lint_files
使用 IntelliJ 检查分析指定文件中的错误和警告。 编辑多个文件后,使用此工具对这些文件执行 lint 检查。 返回每个文件的问题,包括严重性、描述和位置信息。
当单个文件超出可用预算时,批量响应可能包含带有
timedOut: true且problems为空的文件条目。 带有notAnalyzedReason的文件条目表示无法分析的文件,例如项目内容根之外的文件、已排除文件或不支持的文件类型。 顶级more: true表示该批处理不完整。参数:
files(必填):要分析的项目相对文件列表。 规范化后会忽略重复路径。min_severity:要包含的最低严重性:warning或error。 默认值为warning。timeout:超时(毫秒)。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
代码洞察工具
- get_symbol_info
检索指定文件中指定位置的符号信息。 提供与 IntelliJ IDEA 的 快速文档 功能相同的信息。 这些信息可能包括符号的名称、签名、类型、文档及其他详细信息,具体取决于编程语言。
如果该位置引用了某个符号,且声明可用,该工具将返回包含该符号声明的代码片段。 使用此工具了解符号的声明、语义及位置。
参数:
filePath:相对于项目根目录的路径。line:从 1 开始的行号。column:从 1 开始的列号。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
特定数据库工具
可用于: DataGrip 及带有 数据库工具和 SQL 插件的 IDE
要为 AI 代理严格保证只读访问,请使用权限受限(只读)的数据库用户,并将数据源配置为使用该用户。
- cancel_sql_query
使用唯一ID取消正在运行的查询。
参数:
sessionId:查询会话ID。
- create_database_connection
按名称、DBMS(
dbms)、JDBC URL(url)以及用于检查连接的标志(needToCheckDs)创建新的数据库连接(数据源)。 所有参数都是必填项。 返回连接诊断信息。参数:
name(必填):数据库连接的唯一名称。dbms:数据库管理系统(DBMS)的名称。url:数据库连接的完整 JDBC URL,例如jdbc:postgresql://<host>:<port>/<database>。needToCheckDs:是否在创建或编辑数据源后立即测试连接。 批量配置多个连接时设置为false— 每个连接的探测开销很大,并且可以针对重要的连接显式调用test_database_connection。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- edit_database_connection
编辑由
connectionId标识的现有数据库连接(数据源)。 更新连接的 DBMS 驱动程序和 JDBC URL;连接name会保留。 返回连接诊断信息。参数:
connectionId:唯一的连接ID。dbms:数据库管理系统(DBMS)的名称。url:数据库连接的完整 JDBC URL,例如jdbc:postgresql://<host>:<port>/<database>。needToCheckDs:是否在创建或编辑数据源后立即测试连接。 批量配置多个连接时设置为false— 每个连接的探测开销很大,并且可以针对重要的连接显式调用test_database_connection。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- execute_sql_query
对给定的数据库连接执行SQL查询。
工具会报告执行状态:成功或错误。 对于错误,还会提供错误描述。
如查询返回数据,将以 CSV 格式附加在工具响应中。
参数:
connectionId:唯一的连接ID。queryText:要执行的SQL查询。
- fetch_query_result
按 ID 从已执行的查询中提取行,从给定的行偏移量开始。 返回与
execute_sql_query相同的形状:resultSetId以及以 CSV 格式渲染的结果。使用此工具对之前由
execute_sql_query或preview_table_data返回的resultSetId进行分页。参数:
resultSetId(必填):之前的execute_sql_query或preview_table_data调用返回的不透明结果集 ID。offset(必填):开始提取的行偏移量。 默认值为 0。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 获取数据库对象描述
获取特定架构中数据库对象(列、类型、密钥、索引等)的结构,以分层文本方式表示。
如有歧义,将返回所有相关对象的定义。
参数:
connectionId:唯一的连接ID。databaseName:架构所属数据库名称。 如果DBMS只有架构而无数据库,则此项可为空。schemaName:架构名称。kind:将此参数设置为特定对象类型编码,仅列出该类型对象。 若设置为 null,则检索架构中所有对象。objectName:指定类型的对象名称(例如,表或视图名称)。 不得为空。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- introspect_schema
内省数据库架构,将其元数据(表、列和索引)加载到本地模型中。 当架构的
isIntrospected标志为 false 且需要调查架构结构,或刷新过时元数据时,请使用此项。 返回架构标识符以及更新后的内省状态。参数:
connectionId:唯一的连接ID。databaseName:架构所属数据库名称。 如果DBMS只有架构而无数据库,则此项可为空。schemaName:架构名称。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- list_database_connections
检索项目中已配置的数据库连接或数据源列表。 对于每个连接,返回其唯一 ID、名称、DBMS 和驱动程序名称。
- list_database_schemas
检索指定数据库连接中的数据库架构列表。
对于每个架构,工具返回架构自身的名称以及数据库名称(若不适用则为空)。
参数:
connectionId:唯一的连接ID。selectedOnly:若只应列出数据库树中选定的架构,则为 true;若应列出所有架构,则为 false。
- list_recent_sql_queries
此功能在免费订阅方案中不可用。
检索给定数据库连接的最近(包括当前运行中)查询列表。
对于每个查询返回:
查询会话的唯一ID。
查询运行所花费的时间(毫秒)。
查询的当前状态。 例如,运行中、正在取消、已完成等。
查询的完成状态。 例如,成功、错误结束、已取消等。
查询内容文本。
参数:
connectionId:唯一的连接ID。
- list_schema_object_kinds
检索给定数据库连接支持的架构对象类型列表。 对于每种对象类型,返回对象类型唯一代码和可读名称。
参数:
connectionId:唯一的连接ID。
- list_schema_objects
检索指定架构中的数据库对象列表。 针对每个对象,返回其架构下的名称及类型。
参数:
connectionId:唯一的连接ID。schemaName:架构名称。databaseName:架构所属数据库名称。 如果DBMS只有架构而无数据库,则此项可为空。kind:将此参数设置为特定对象类型编码,仅列出该类型对象。 若设置为 null,则检索架构中所有对象。
- preview_table_data
使用指定数据库连接返回表、视图、物化视图或其他类表对象的预览数据。
工具以CSV格式返回表内容。
参数:
connectionId:唯一的连接ID。schemaName:架构名称。databaseName:架构所属数据库名称。 如果DBMS只有架构而无数据库,则此项可为空。tableName:表名称。maxRowCount:返回的最大行数。 默认值为100。
- test_database_connection
返回连接诊断信息:
指示连接是否有问题的标志:是、否或未知。
关于数据库连接的详细信息,如 DBMS 类型、版本及 JDBC 驱动。
连接尝试结果摘要。 如失败,则包含由DBMS提供的错误描述。
参数:
id:唯一的连接ID。
调试器工具
可用于: IntelliJ IDEA Ultimate、CLion、RubyMine
这些工具让外部客户端可以控制 IDE 的调试器:它可以设置、列出和移除断点,启动调试会话并逐步执行,还可以在运行时检查调用堆栈、线程和变量值。
要改进外部客户端使用 IDE 调试器工具的方式,可以为其安装特定技能。 此技能随 IDE 捆绑提供,并会指导外部客户端何时应用调试器工具。
要为外部客户端安装技能:
转到 。
导航到 捆绑技能 部分并找到相应技能。 它默认已启用,但仅可供 IDE 内部的代理使用。
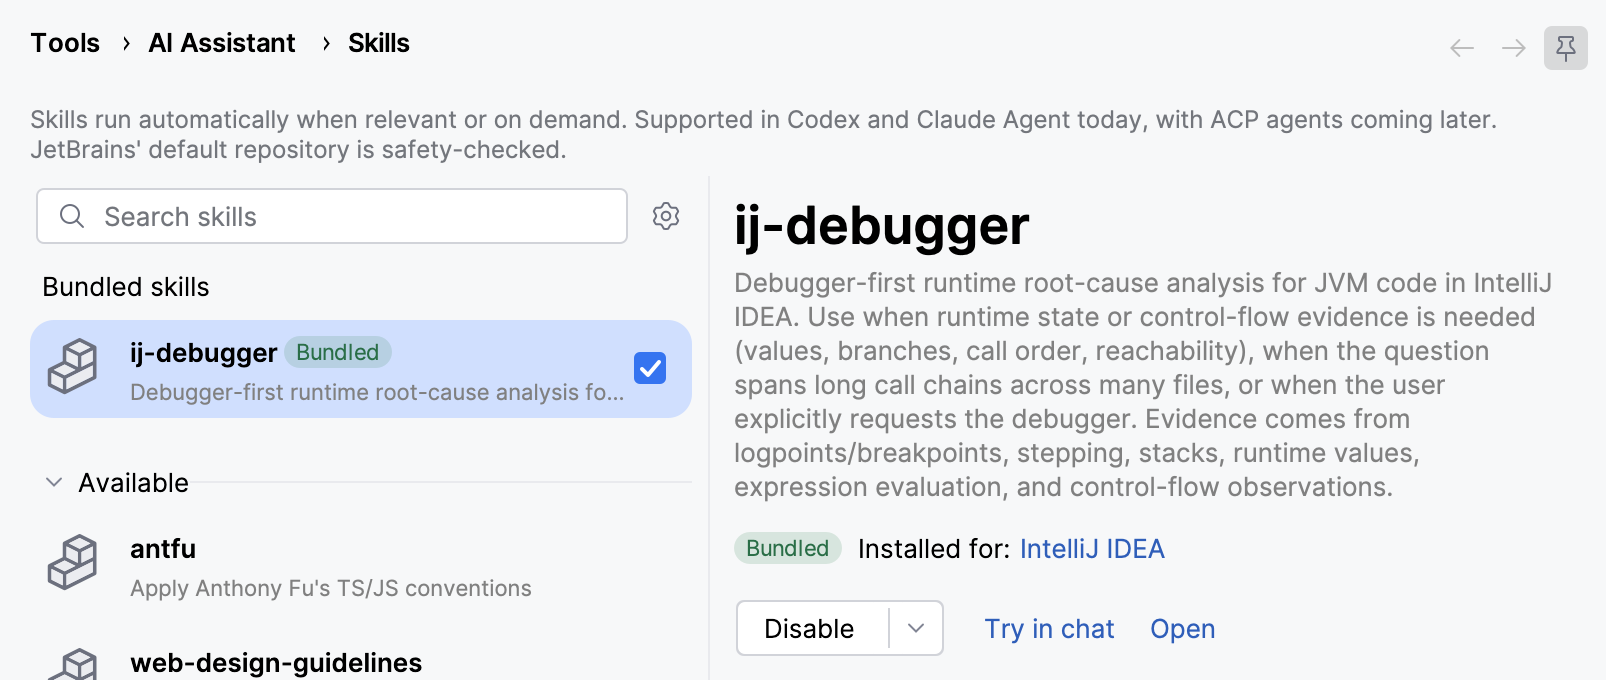
要在 IDE 外部的 Claude Code 或 Codex 中使用此技能,需要为这些客户端显式安装它。 为此,请点击
,然后根据要使用的客户端选择 Claude Agent (全局) 或 Codex (全局)。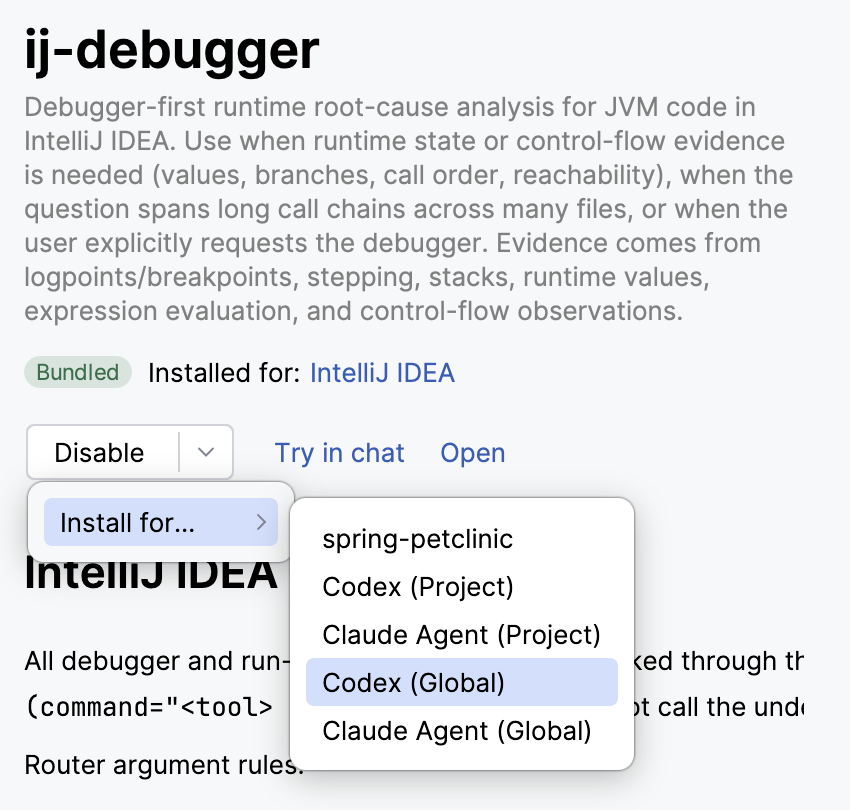
根据选择的目标,技能会安装到以下文件夹:
Claude Code:
%USERPROFILE%\.claude\skills\ij-debugger\
~/.claude/skills/ij-debugger/
~/.claude/skills/ij-debugger/
Codex:
%USERPROFILE%\.codex\skills\ij-debugger\
~/.codex/skills/ij-debugger/
~/.codex/skills/ij-debugger/
如需在外部客户端调用此技能,请使用 /ij-debugger ,或在相关时自动激活。
- xdebug 控控制会话
控制调试会话的执行过程。 可用此工具逐步执行代码、恢复执行、暂停或停止调试会话。
前提条件:
需存在调试会话。
STEP_*和RESUME需要会话暂停。
操作:
STEP_INTO :步入下一个方法调用
STEP_OVER :步过当前行
STEP_OUT :步出当前方法
RESUME :恢复程序执行,直至下一个断点
PAUSE :暂停程序执行
STOP :停止调试会话
WAIT_FOR_PAUSE :等待会话暂停(命中断点或手动暂停)
DRAIN_EVENTS :提取会话的跟踪点输出(所有操作的断点错误均被提取)
重要说明:
如程序正在运行,请在 WAIT_FOR_PAUSE或 PAUSE前使用
STEP_*/RESUME。请使用来自
xdebug_get_debugger_status或xdebug_start_debugger_session的当前sessionId。 如会话已停止、超时或消失,下次涉及会话的调用前请刷新会话列表。RESUME不会设置断点。 如无已启用断点(或下一个不会命中任何断点),程序可能直接运行至结束,会话将不经过暂停而停止。
RESUME后,需调用 WAIT_FOR_PAUSE以确认下次挂起。 如 WAIT_FOR_PAUSE超时,请考虑 PAUSE并重新检查断点。
DRAIN_EVENTS同样需要现有会话,终止后请勿复用过期的
sessionId。
下次调用:
RESUME后,调用
xdebug_control_session(action=WAIT_FOR_PAUSE)。收到暂停结果后,调用
xdebug_get_stack/xdebug_get_frame_values/xdebug_evaluate_expression。
结果中的状态值:
running :程序正在执行
paused :执行已暂停(断点、步进或手动暂停);暂停结果还会包含
frameValues,即当前帧的xdebug_get_frame_values(depth=0)格式快照(如可用)stopped :调试会话已终止
breakpointErrorsTail会针对任意操作返回tracepointOutputsTail只会针对 DRAIN_EVENTS 返回
事件支持范围:
断点错误和跟踪点输出事件目前仅由基于 JVM 的调试器(Java、Kotlin 等)上报。
在其他调试器后端,即便已配置断点/日志,这些事件尾部也可能为空。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。action:所要执行的操作: STEP_INTO、 STEP_OVER、 STEP_OUT、 RESUME、 PAUSE、 STOP、 WAIT_FOR_PAUSE、 DRAIN_EVENTS。 事件提取目前仅适用于基于 JVM 的调试器(如 Java、Kotlin 等)。timeout:等待操作完成的超时时间,单位为毫秒。 指导: STEP_*/PAUSE 通常为 5000-15000; WAIT_FOR_PAUSE 通常为 30000-120000,视工作负载和断点情况而定。 默认: 30000。eventsLimit:每个事件列表要提取的最新事件的最大数量。 针对 DRAIN_EVENTS ,此限制会分别应用于breakpointErrorsTail和tracepointOutputsTail。 默认: 100。clearEventsAfterRead:兼容性标志。 已返回的事件始终会从内部缓存中移除,无论此值为何。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 计算表达式
在当前堆栈帧上下文中计算表达式。 可用此工具在调试期间计算值、调用方法或检查表达式。
前提条件:
会话需已暂停。
所选帧/语言需支持计算。
expression必须为当前帧所用语言的有效表达式。
结果返回格式为:
depth == 0:仅为表达式计算结果的展示depth > 0:为计算结果的展示和最多到请求深度的子项伪图结构树
输入规则:
请准确传递原始表达式文本,确保调试器求值程序能正确解析。
请勿传递 JSON 转义的载荷或类似
\\"text\\"这样的文字转义序列。
下次调用:
如表达式验证了假设,继续执行
xdebug_control_session(STEP_*|RESUME)。如果需要更多详细信息,请通过
xdebug_get_frame_values/xdebug_get_value_by_path检查相关值。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。frameIndex:堆栈帧索引(整数,0 = 顶部帧)。 从当前暂停的xdebug_get_stack结果中获取此值;在 RESUME、 STEP_*、xdebug 运行到行或暂停位置发生变化后,切勿重复使用已缓存的帧索引。 如果为 null,则使用顶部帧。 默认值为 null。expression:在当前上下文中要计算的表达式。 传递当前帧语言的原始表达式文本;请勿传递经过 JSON 转义的有效负载或反斜杠转义的引号文本。depth:展开已计算结果子级的最大深度(0 = 只显示值,1 = 直接子级,2 = 子级+孙级,依此类推)。 默认值:0。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 获取调试器状态
返回调试器的当前状态,包括所有活动的调试会话。 使用此工具可查看所有正在运行的调试会话及其状态概览。
前提条件:
无。
返回显式
sessions[]和activeSessionId。下次调用:
如果没有会话正在运行,请调用
xdebug_start_debugger_session。如有多个会话处于活动状态,请在后续调用中将返回的
id作为sessionId使用。
参数:
projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 获取帧值
以树结构返回指定堆栈帧中可见的值。 使用此工具可查看调用堆栈中特定点可用的局部变量、参数、字段或其他值。
前提条件:
会话需已暂停。
帧索引应来自当前暂停的
xdebug_get_stack结果(0 = 顶部帧)。
格式:
有子项的节点会用
+标记。
下次调用:
使用
xdebug_get_value_by_path可深入查看嵌套字段。在同一帧内,使用
xdebug_evaluate_expression进行计算检查。在 RESUME、 STEP_*、
xdebug 运行到行或暂停位置有变化后,切勿复用已缓存的frameIndex。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。frameIndex:堆栈帧索引(整数,0 = 顶部帧)。 从当前暂停的xdebug_get_stack结果中获取此值;在 RESUME、 STEP_*、xdebug 运行到行或暂停位置发生变化后,切勿重复使用已缓存的帧索引。 如果为 null,则使用顶部帧。 默认值为 null。depth:展开已计算结果子级的最大深度(0 = 只显示值,1 = 直接子级,2 = 子级+孙级,依此类推)。 默认值:0。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 获取调用栈
返回调试会话中某个线程的调用堆栈。 使用此工具可查看导致当前执行点的方法调用序列。
前提条件:
会话需已暂停。
行为:
threadId应该来自xdebug_get_threads,并与调试器线程显示名称匹配(默认为活动线程)。即使缺少源位置,也包括帧(
file/line可能为 null)。
分页:
offset/limit在收集完整堆栈后应用。
帧字段包括:
indexfilelineisCurrentpresentation
file以调试器提供的方式报告(无路径规范化)。下次调用:
在
xdebug_get_frame_values、xdebug_get_value_by_path或xdebug_evaluate_expression中使用当前暂停结果的帧索引。在 RESUME、 STEP_*、
xdebug 运行到行或暂停位置有变化后,切勿复用已缓存的frameIndex。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。threadId:要获取堆栈的线程 ID。 该值应来自xdebug_get_threads,并与调试器线程显示名称匹配,而不是不透明的数字 ID。 如果未指定,则使用当前/活动线程。 默认值为 null。limit:要返回的最大帧数。 默认值:200。offset:页偏移。 默认值:0。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 获取线程
返回调试会话中的线程列表。 使用此工具可查看所有线程及其当前状态。
前提条件:
会话需已暂停。
下次调用:
对于所选线程,使用
xdebug_get_stack。
分页:
在收集所有堆栈后应用
offset/limit。
排序:
活动线程优先。
其余线程按堆栈深度递减排序。
架构字段包括:
idnamestateisCurrentadditionalInfoadditionalInfoTooltipframeCount
additionalInfo/additionalInfoTooltip在可用时会使用更多显示信息。参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。limit:页面大小。 默认:50,最大值:200。offset:页偏移。 默认值:0。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 通过路径获取值
通过属性名称路径获取嵌套对象的值。 使用此工具可深入复杂对象并查看其嵌套属性。
前提条件:
会话需已暂停。
路径不能为空,且必须引用所选帧/对象中可见的名称。
结果返回格式为:
depth == 0:仅呈现指定路径值的展示depth > 0:就是值的展示以及其子项的伪图形树,至请求的深度
示例:
要获取
obj.field.subField的值,请使用path = ["obj", "field", "subField"]。对于数组/列表索引器,将索引标记作为常规路径元素(子项名称)传递,例如
items[0].name->path = ["items", "[0]", "name"]。请使用当前暂停
xdebug_get_frame_values/ 前一次xdebug_get_value_by_path输出结果中精确的子项名称,因为不同语言/调试器的索引节点名称可能不同(例如"[0]"与"0")。在 RESUME、 STEP_*、
xdebug 运行到行或暂停位置有变化后,刷新path标记。
下次调用:
如需进一步深入,请再次调用
xdebug_get_value_by_path。当直接名称路径导航不够时,请使用
xdebug_evaluate_expression。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。frameIndex:堆栈帧索引(整数,0 = 顶部帧)。 从当前暂停的xdebug_get_stack结果中获取此值;在 RESUME、 STEP_*、xdebug 运行到行或暂停位置发生变化后,切勿重复使用已缓存的帧索引。 如果为 null,则使用顶部帧。 默认值为 null。path:要导航的子项名称列表,例如['myObject', 'field', 'subField']或['items', '[0]', 'name']。 请使用当前暂停xdebug_get_frame_values/xdebug_get_value_by_path输出的精确节点名称,并在暂停位置变更时刷新过期路径标记。depth:展开已计算结果子级的最大深度(0 = 只显示值,1 = 直接子级,2 = 子级+孙级,依此类推)。 默认值:0。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 列出断点
列出项目中或指定文件中的所有断点。 使用此工具可查看所有当前设置的断点及其属性。
行为:
如果提供了
filePath,则仅返回该文件中的断点。为每个断点返回丰富的属性(
id、type、file、line、enabled、owner、condition、isLogMessage、isLogStack、temporary、suspendPolicy、hitCount)。
下次调用:
如果不存在合适的断点,请调用
xdebug_set_breakpoint。然后使用
xdebug_control_session(action=RESUME)和xdebug_control_session(action=WAIT_FOR_PAUSE)继续执行。
参数:
filePath:可选的文件路径,用于筛选断点。 文件路径。 支持项目相对路径、带有 .. 的路径、绝对路径、如 /path/lib.jar!/pkg/Foo.class 的归档条目,以及例如 file:// 、 jar:// 和 jrt:// 的 URL。 可以直接传递其他工具返回的任何路径(如来自search_*工具的路径)。 如果未指定,则返回所有断点。 默认值为 null。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 删除断点
按所有者和可选选择器筛选移除断点。 使用此工具移除已设置的断点。
行为:
owner默认为agent。仅提供
owner时,移除该所有者的所有断点。如果提供
breakpointId,则移除所选所有者下匹配的断点(们)。如果同时提供
filePath+line,则移除所选所有者下匹配的行断点(们)。如提供多个选择器,则全部组合(逻辑与)。
幂等:移除不存在的断点会返回
removed=false。如需移除所有断点(无论所有者),请调用两次:一次用
owner=user,一次用owner=agent。
下次调用:
使用
xdebug_list_breakpoints验证剩余集合。
参数:
breakpointId:由xdebug_set_breakpoint或xdebug_list_breakpoints返回的规范断点 ID。filePath:可选的文件路径,用于筛选断点。 文件路径。 支持项目相对路径、带有 .. 的路径、绝对路径、如 /path/lib.jar!/pkg/Foo.class 的归档条目,以及例如 file:// 、 jar:// 和 jrt:// 的 URL。 可以直接传递其他工具返回的任何路径(如来自search_*工具的路径)。 如果未指定,则返回所有断点。 默认值为 null。line:可选输入,欲移除断点的行号(从 1 开始)。owner:断点所有者筛选器。 默认值:agent。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 运行到行
恢复执行至目标行。 使用此工具可以运行到特定源代码位置,无需手动步进。
前提条件:
会话需已暂停。
目标文件/行必须有效。
结果:
paused:会话暂停在目标行或之后。stopped:会话在暂停前已终止。timeout:在超时窗口内未暂停/停止。
下次调用:
如果已暂停,请调用
xdebug_get_stack/xdebug_get_frame_values/xdebug_evaluate_expression。如会话已停止或消失,在发起另一会话范围调用前,请通过
xdebug_get_debugger_status刷新sessionId。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。filePath:相对于项目根目录的路径。line:目标行号(从 1 开始)。timeout:等待暂停/停止结果的超时时间,单位为毫秒。 默认: 30000。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 设置断点
创建或更新断点。 使用此工具可设置行断点、根据 ID 更新现有断点并控制跟踪点/日志行为。
目标模式:
按位置:提供
filePath+line,且省略breakpointId(或传入null)。 请勿使用""、"/"或"__omit__"这样的占位符字符串。按 ID:提供
xdebug_set_breakpoint或xdebug_list_breakpoints返回的现有不透明规范breakpointId(可选的filePath/line可移动行断点)。
验证:
位置模式下,必须同时提供
filePath和line。ID 模式下,断点必须存在,并被
breakpointId唯一标识。位置模式下,
filePath相对于项目根目录,line从 1 开始,且目标位置必须可执行。
事件上报:
无效的
condition表达式会通过xdebug_control_session(...).breakpointErrorsTail进行异步上报。带有
isLogMessage和/或isLogStack的断点,其跟踪点输出通过xdebug_control_session(action=DRAIN_EVENTS).tracepointOutputsTail排出。断点错误和跟踪点输出仅由基于 JVM 的调试器(Java、Kotlin 等)当前支持。
xdebug_set_breakpoint响应成功并不保证condition或跟踪点表达式有效;请稍后检查breakpointErrorsTail后再依赖相关内容。成功的行断点响应还包含
lineText,即断点现在所处的实际源代码行的截断片段。 请在恢复前检查,以确认位置正确。
应用语义:
已提供的字段将被应用为目标断点的结果状态。
condition=null会清除已有条件。isLogMessage=true记录断点命中位置。isLogStack=true记录当前堆栈跟踪。如两个标志都为 true,则同时记录位置和堆栈。
有
isLogMessage/isLogStack+suspendPolicy=NONE时,断点作为跟踪点行为。在 ID 模式下,如果为行断点提供
filePath/line,则会在新位置重新定位(重新创建)该断点。在 ID 模式下,对于非行断点,
filePath/line会被忽略,并在message中报告。任何成功的操作都会将断点标记为
agent所有权(mcpBreakpointMarker)。
下次调用:
请使用返回的
lineText和/或xdebug_list_breakpoints验证位置。通过
xdebug 启动调试器会话或xdebug_control_session(action=RESUME)启动/继续执行。
参数:
breakpointId:由xdebug_set_breakpoint或xdebug_list_breakpoints返回的规范断点 ID。filePath:可选的文件路径,用于筛选断点。 文件路径。 支持项目相对路径、带有 .. 的路径、绝对路径、如 /path/lib.jar!/pkg/Foo.class 的归档条目,以及例如 file:// 、 jar:// 和 jrt:// 的 URL。 可以直接传递其他工具返回的任何路径(如来自search_*工具的路径)。 如果未指定,则返回所有断点。 默认值为 null。line:从 1 开始的行号。 仅在定位模式下必填。 在 ID 模式下可选用于重新定位行断点。condition:可选条件表达式——只有当该表达式为 true 时断点才会触发。 验证错误将通过xdebug_control_session(...).breakpointErrorsTail异步报告(仅适用于基于 JVM 的调试器)。 默认值为 null。isLogMessage:当断点被命中时,是否记录其位置(源位置)。 在基于 JVM 的调试器中,输出可通过xdebug_control_session(action=DRAIN_EVENTS).tracepointOutputsTail获取。 默认值:false。isLogStack:当断点被命中时,是否记录堆栈跟踪。 在基于 JVM 的调试器中,输出可通过xdebug_control_session(action=DRAIN_EVENTS).tracepointOutputsTail获取。 默认值:false。temporary:临时断点(首次命中后被移除)。 默认值:false。suspendPolicy:挂起策略: ALL、 THREAD、 NONE。 默认值: ALL。enabled:断点是否启用。 默认值:true。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 设置变量
在所选堆栈帧中按路径修改变量值。 使用此工具在调试期间更改状态。
前提条件:
会话需已暂停。
值必须可修改。
path应来自当前暂停的xdebug_get_frame_values/xdebug_get_value_by_path输出。
路径格式与
xdebug_get_value_by_path中相同。newValue必须是当前帧语言中的原始表达式,并且调试器/评估器必须能够将其赋值给目标值。 不要传递 JSON 转义的载荷或如\\"text\\"这样的转义序列。结果:
返回
oldValue/newValue/applied。不支持的变量修改会返回带文本信息的错误。
下次调用:
通过
xdebug_get_value_by_path或xdebug_get_frame_values重新读取值以确认。
参数:
sessionId:调试会话 ID。 请使用xdebug_get_debugger_status或xdebug_start_debugger_session返回的当前 ID。 如会话已停止、超时或消失,重新使用旧 ID 前需刷新会话列表。 格式:默认使用会话名作为 ID;若有多个会话同名,则 ID 为<sessionName>#<executionId>。 如为 null 且恰好只有一个活动会话,则自动选择。 如有多个活动会话且未指定sessionId,则调用会失败。 默认值为 null。frameIndex:堆栈帧索引(整数,0 = 顶部帧)。 从当前暂停的xdebug_get_stack结果中获取此值;在 RESUME、 STEP_*、xdebug 运行到行或暂停位置发生变化后,切勿重复使用已缓存的帧索引。 如果为 null,则使用顶部帧。 默认值为 null。path:目标值的路径,格式与xdebug_get_value_by_path相同。 请使用当前暂停的xdebug_get_frame_values/xdebug_get_value_by_path输出中的精确节点名称,并在暂停位置变化时刷新过期的路径标记。newValue:要分配的新值表达式。 请传递当前帧语言中的原始表达式文本;调试器/评估器必须能够将其赋值给目标值。 不要传递 JSON 转义的载荷或带反斜杠转义的引号文本。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- xdebug 启动调试器会话
为当前项目中的已存在运行配置(通过名称)或代码位置(
filePath+line)启动调试器会话。 使用此工具启动调试器会话。 使用此工具,可通过现有运行配置名称或filePath+line启动会话。 当使用filePath+line时,包含可运行方法(如main)、测试或其它可执行入口点的行几乎总是可用。 如果不确定使用哪一行,get_run_configurations可以帮助发现文件中可运行的位置。 会话将启动,之后可用其他调试器工具控制执行。前提条件:
当使用
configurationName时,请传递精确的现有运行配置名称;不要传递测试方法名或其他派生目标标识符。当使用
filePath+line时,请指向可运行的代码位置,如main、测试或其他可执行入口点。请先设置至少一个断点,否则程序可能会直接执行完毕而不暂停。
请传递
configurationName,或同时传递filePath和line。 这些模式互斥。
行为:
等待会话创建,最长不超过
timeout。在会话启动后应用宽限期等待(
graceWaitMs)并返回刷新后的状态。可选启动覆盖参数(
programArguments、workingDirectory、envs)仅对本次调试启动生效,并不会被持久化。get_run_configurations是覆盖支持的依据:仅当所选运行配置报告supportsDynamicLaunchOverrides=true时传递启动覆盖。除非明确需要更改本次调试启动的配置值,否则不要传递这些覆盖参数。
缺失/null 的覆盖参数会保留现有运行配置值不变。
对于字符串覆盖(
programArguments、workingDirectory),缺失/null 或空字符串("")将保持现有值不变。如需清除本次调试启动的现有值,可传递仅包含空白字符的字符串,如
" "。
下次调用:
xdebug_control_session(action=WAIT_FOR_PAUSE)用于等待第一次挂起。暂停后,请调用
xdebug_get_stack和xdebug_get_frame_values(或xdebug_evaluate_expression) 获取运行时证据。
返回的平面结果包含调试器会话元数据以及运行快照字段:
sessionId、name、status,以及可选的runConfigurationNameoutput预览,以及可选的fullOutputPath当进程终止已经知晓时,可选的
exitCode
参数:
configurationName:要调试的现有运行配置名称。filePath:相对于项目根目录的文件路径。 请与line一起提供,以便从代码位置开始调试。line:用于filePath的从 1 开始的行号。 请与filePath一起提供,且不要与configurationName组合。timeout:等待调试会话启动的超时时间,单位为毫秒。 默认值:60000。graceWaitMs:会话开始后用于刷新状态的宽限等待时间,单位为毫秒。 默认值:2000。programArguments:仅本次启动生效的可选程序参数覆盖。 仅当所选运行配置在get_run_configurations中报告supportsDynamicLaunchOverrides=true时传递。 缺失/null 或空字符串会保持现有值不变,仅空白字符串会清除该值。workingDirectory:仅本次启动生效的可选工作目录覆盖。 仅当所选运行配置在get_run_configurations中报告supportsDynamicLaunchOverrides=true时传递。 缺失/null 或空字符串会保持现有值不变,仅空白字符串会清除该值。envs:仅本次启动生效的可选环境变量覆盖。 仅当所选运行配置在get_run_configurations中报告supportsDynamicLaunchOverrides=true时传递。 缺失/null 会保持现有环境变量不变;如有提供,则会将其值覆盖合并到现有环境中。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
执行工具
- execute_run_configuration
运行当前项目中按名称的现有运行配置,或由代码位置(
filePath+line)创建的临时运行配置,并等待其在指定超时时间内完成。 使用此工具,可以选择通过get_run_configurations返回的配置名称,或通过get_run_configurations(filePath = ...)返回的运行点(filePath+line)运行。可选启动覆盖(
programArguments、workingDirectory、envs)仅对本次运行生效,且不会被持久化。 除非明确需要更改本次运行的配置值,否则不要传递这些覆盖参数。 缺失/null 的覆盖参数会保留现有运行配置值不变。 对于字符串覆盖(programArguments、workingDirectory),缺失/null 或空字符串("")会保持现有值不变。 如需清除本次运行的现有值,可传递仅包含空白字符的字符串,如" "。请传递
configurationName,或同时传递filePath和line。 这些模式互斥。行为:
当
waitForExit=true时,最多等timeout毫秒等待进程结束。 如果超时时间到,进程会在后台继续运行,exitCode不会出现在结果中。当
waitForExit=false时,仅等待进程启动,然后立即返回,不应用timeout。fullOutputPath指向一个包含全部原始输出的临时文件,在进程存活期间可能会继续增长。
返回执行结果,包括当前输出快照、可选退出码,以及可选
fullOutputPath。参数:
configurationName:要执行的现有运行配置的名称。filePath:相对于项目根目录的文件路径。 请与line一起提供,以从代码上下文创建并执行临时运行配置。line:用于filePath的从 1 开始的行号。 请与filePath一起提供,且不要与configurationName组合。timeout:超时(毫秒)。waitForExit:是否等待进程结束。 如果为 false,工具会在进程启动后立即返回,并忽略timeout。programArguments:仅本次启动生效的可选程序参数覆盖。 缺失/null 或空字符串会保持现有值不变,仅空白字符串会清除该值。workingDirectory:仅本次启动生效的可选工作目录覆盖。 缺失/null 或空字符串会保持现有值不变,仅空白字符串会清除该值。envs:仅本次启动生效的可选环境变量覆盖。 缺失/null 会保持现有环境变量不变;如有提供,则会将其值覆盖合并到现有环境中。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_run_configurations
根据输入,返回项目运行配置或可执行代码位置。
未提供
filePath时,该工具会列出项目中现有的运行配置。 结果包括配置名称,以及在有可用信息时,还包括启动详情,例如程序参数、工作目录、环境变量和supportsDynamicLaunchOverrides。supportsDynamicLaunchOverrides是execute_run_configuration和xdebug_start_debugger_session中一次性启动重写(programArguments、workingDirectory、envs)的权威功能标志。 仅当该标志为true时,才为所选配置传递这些重写参数。通过
filePath,该工具会在该文件中发现可执行入口点(运行点),例如测试方法、main 方法或 IDE 显示运行装订区域图标的其他可执行入口点。 结果包含filePath和runPoints;请结合返回的行号和execute_run_configuration从代码运行。参数:
filePath:相对于项目根目录的可选文件路径。 提供该参数时,将返回文件中的运行点(可执行入口点),而不是项目级别的运行配置。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
文件工具
- create_new_file
在项目目录中的指定路径创建新文件。 可选择将提供的文本写入该文件。
参数:
pathInProject:应创建文件的路径,相对于项目根目录。text(可选):要写入新文件的内容。overwrite:是否覆盖现有文件。 如果设置为false,发生冲突时将抛出异常。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_all_open_file_paths
返回在活动编辑器或任何其他已打开的编辑器中打开进行编辑的所有文件的路径,相对于项目根目录。 使用此工具探索当前打开的编辑器。
参数:
projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- list_directory_tree
以伪图形格式提供指定目录的树形表示,类似于
tree实用工具。 使用此工具浏览目录或整个项目的内容。 列出目录时,优先使用此工具,而非ls或dir等命令行实用工具。参数:
directoryPath:相对于项目根目录的路径。maxDepth:最大递归深度。timeout:超时(毫秒)。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- open_file_in_editor
在 JetBrains IDE 编辑器中打开指定文件。 需要一个
filePath参数,其中包含要打开的文件路径。 文件路径可以是绝对路径,也可以是相对于项目根目录的路径。参数:
filePath:相对于项目根目录的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
格式设置工具
- reformat_file
在 JetBrains IDE 中重新格式化指定文件。 使用此工具对通过其路径标识的文件应用代码格式化。
参数:
path:相对于项目根目录的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
Jupyter Notebook 工具
可用于: PyCharm
要改进外部客户端处理 Jupyter Notebook 的方式,可以使用捆绑的 jupyter 技能。 该技能提供有关何时以及如何使用相应 Notebook 工具的指导。
- create_notebook
创建一个带有
.ipynb扩展名的空 Jupyter Notebook 文件。 该 Notebook 使用nbformat4.5 架构。创建 Notebook 后,使用
edit_notebook添加单元格。该工具返回新文件的路径。
参数:
file_path:应创建 Notebook 的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- edit_notebook
编辑 Jupyter Notebook 中的单元格,并保存更新后的 Notebook 文件。
可以替换、插入或删除单元格。 如果找不到指定的单元格,该工具会返回验证错误以及可用的单元格 ID。
示例:
{"file_path": "/abs/path/demo.ipynb", "cell_id": "abc123", "new_source": "print('hello')", "edit_mode": "replace"}{"file_path": "/abs/path/demo.ipynb", "cell_id": "abc123", "new_source": "# Title", "cell_type": "markdown", "edit_mode": "insert"}{"file_path": "/abs/path/demo.ipynb", "cell_id": "abc123", "edit_mode": "delete"}
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。cell_id:要替换或删除的单元格 ID。 对于插入,新单元格会添加到此单元格之后。 如果在插入模式下省略,新单元格会追加到 Notebook 末尾。new_source:新单元格或替换单元格的源文本。 仅在创建或替换内容为空的单元格时省略它。cell_type:单元格类型,可以是code或markdown。 插入时必需;替换和删除时会被忽略。edit_mode:要执行的编辑操作:replace、insert或delete。 默认值为replace。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- execute_code_on_kernel
在 Jupyter Notebook 的活动内核中运行一个简短的代码段,而不修改 Notebook。
使用此工具进行快速检查,例如检查变量、指标、数据形状或执行环境。 对于应保留在 Notebook 中的较长操作,请添加或编辑单元格并使用
run_notebook_cell。此工具需要现有的 Jupyter 内核会话。 它会返回最后一个文本输出中的紧凑文本或错误消息。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。code:要在 Notebook 内核中运行的代码段。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_notebook_state
检查 Jupyter Notebook 内核的当前执行状态,而不启动新的内核会话。
此工具会报告内核是不可用、空闲还是忙碌。 如果此信息可用,它还会包含当前正在执行的单元格 ID 和已排队单元格的 ID。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- interrupt_notebook
中断 Jupyter Notebook 中的当前执行,同时保持内核会话可用。
使用此工具停止卡住或不再需要的单元格。 如果没有可用的活动 Notebook 执行管理器,此工具会报告内核已停止。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- kill_notebook
终止与 Notebook 关联的 Jupyter 内核会话。
当需要重置内核状态、导入、变量或内存,或者需要从干净状态重新运行 Notebook 时,请使用此工具。 下一次单元格执行会启动新的内核会话,因此必须重新运行初始化和导入单元格。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- read_notebook
读取 Jupyter Notebook 的内容,而不执行任何单元格。
此工具会按原始顺序返回 Notebook 单元格,包括每个单元格的 ID、类型、可用时的执行状态、源代码和渲染后的输出。 支持的输出包括文本、Markdown、JSON、错误、图像、浏览器内容和表格。
图像会保存为临时 PNG 文件,表格会渲染为简单的 HTML。 由于 Notebook 级响应的大小有限,请使用
read_notebook_cell检查单个大型单元格。file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- read_notebook_cell
读取 Jupyter Notebook 中的特定单元格,而不执行它。
此工具可以返回单元格源、其输出或两者。 它会将结果格式化为紧凑的类 XML 块。
大型输出会作为预览返回,并附带一个包含完整输出的临时文本文件。 图像输出会保存为临时 PNG 文件。 对于动态表格,此工具会尝试在 10 秒内加载前 100 行和统计信息,然后回退到静态表格表示形式。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。cell_id:要读取的 Notebook 单元格的 ID。read_mode:要返回的内容,all表示源和输出,source表示仅源,或output表示仅输出。output_mode:要返回的输出范围。 使用delta仅返回自此单元格上一次调用以来添加的输出,或使用full返回完整输出。 默认值为delta。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- run_notebook_cell
使用 Notebook 内核在 Jupyter Notebook 中运行一个或多个单元格。
当 Notebook 执行必须产生副作用或更新后的单元格输出时,请使用此工具。 对于已在运行的内核中的简短检查,请改用
execute_code_on_kernel。此工具会等待请求的单元格完成,并返回其渲染后的输出。 大型输出会作为预览返回,并附带一个包含完整输出的临时文本文件。 图像输出会保存为临时 PNG 文件。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。cell_ids:要运行的单元格 ID 可选列表。 如果省略,则按顺序执行所有单元格。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- wait_cell_execution
等待 Jupyter Notebook 单元格完成执行或达到另一个终止状态。
对于运行时几乎不产生有用输出或不产生有用输出的长时间运行单元格,请使用此工具。 对于包含增量日志或其他有用实时输出的单元格,请使用
read_notebook_cell,并将output_mode设置为delta。如果等待期结束时单元格仍在运行,此工具会返回正常状态,指示执行仍在进行中。 再次调用此工具以继续等待。
参数:
file_path:指向.ipynb文件的绝对路径或相对于项目根的路径。cell_id:要等待其执行状态的 Notebook 单元格的 ID。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
Inspection Generator MCP 工具
- 验证检查 KTS
针对规范示例验证 inspection.kts 脚本。 编译该检查,并使用正/反例运行。 返回编译状态和详细验证结果。
正例应触发检查(预期存在问题)。 反例不应触发检查(在禁止行上不应有问题)。
返回整体成功情况、每个示例结果以及聚合统计信息。
参数:
inspectionKtsCode:要编译和验证的 inspection.kts 脚本内容。pathToSpecification:带有要验证示例的规范路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
检查 KTS MCP 工具
- 生成检查 KTS API
返回目标语言的 Inspection KTS API 文档。 提供可用于编写 inspection.kts 文件时的可用类和函数。
参数:
language:目标语言:“Java” 或 “Kotlin”。wrapInTags:如为 true,则将 API 内容包裹在<API>和<api.kt>标记中。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 生成检查 KTS 示例
返回用于目标语言代码生成指导的示例 inspection.kts 模板。 提供如何使用 InspectionKts API 编写检查的 XML 包裹示例。
参数:
language:目标语言:“Java” 或 “Kotlin”。includeAdditionalExamples:如为 true,则除模板外还包含额外精心整理的示例。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 生成 PSI 树
为所提供的 Java 或 Kotlin 代码创建 PSI 树,并以缩进文本的形式返回。 使用此工具,可在编写检查时了解代码段的 PSI 结构。 输出显示元素类型及其层次结构,并提供何时需要
node.children()的提示。参数:
code:要解析的源代码段。language:目标语言:“Java” 或 “Kotlin”。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 运行检查 KTS
编译 inspection.kts 脚本并针对目标文件运行。 如果有,返回编译错误,否则返回检查发现的问题列表。 使用该工具在开发过程中测试 inspection.kts 脚本。
参数:
inspectionKtsCode:要编译和运行的 inspection.kts 脚本内容。contextPath:项目内待分析目标文件的相对路径(例如: src/my/package/Example.kt )。targetFileContent:待分析的目标文件内容。 如未提供,则文件必须在项目中存在。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
补丁工具
- apply_patch
应用 Codex
apply_patch格式或统一 Git diff 格式的补丁。 支持 Add、Delete 和 Update 操作,并为更新提供可选的移动目标路径。 路径必须保留在项目目录内。参数:
input:采用apply_patch格式或统一 Git diff 格式的补丁文本。patch:input的别名,用于与发送{patch: ...}的客户端兼容。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
Python 环境 MCP
可用于: PyCharm
为了改进外部客户端使用 Python 环境的方式,可以使用捆绑的 python-tools 技能。 此技能提供有关何时以及如何使用相应环境工具的指导。
- configure_python_interpreter
为包含指定文件的模块配置本地 Python 解释器。
AI Assistant 可以附加现有虚拟环境、从父模块继承解释器,或使用可用的环境管理器创建新环境。
仅当
get_python_environment的响应指示 AI Assistant 可以配置解释器时,才调用此工具。 配置后,再次调用get_python_environment以验证环境。参数:
filePath:应为其配置解释器的模块中 Python 文件的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- get_python_environment
返回为指定文件配置的 Python 环境相关信息。
在运行 Python 命令之前,使用此工具确定 AI Assistant 使用的解释器版本、环境类型、可执行文件路径、环境位置和软件包管理器。 此工具不会修改项目配置。
如果未配置解释器,响应会包含有关下一步操作的提示。 如果响应指示 AI Assistant 可以配置解释器,请使用相同文件路径调用
configure_python_interpreter。参数:
filePath:目标模块中 Python 文件的绝对路径或相对于项目根的路径。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
读取工具
- 读取文件
读取项目目录或任何项目依赖项或其他项目源根目录内的文件。 可读取 Jar/Jrt 文件内的源文件,并反编译 Jar/Jrt 文件内或磁盘上的 Java 类文件。 以文本形式返回带编号的行(从 1 起始)。
模式:
slicelinesline_columnsoffsetsindentation
模式详情:
slice使用start_line和max_lines。lines使用start_line/end_line(包含两端)。line_columns使用start_line/start_column和end_line/end_column(end不包括在内;end_line默认为start_line)。offsets使用start_offset/end_offset(end不包括在内)。indentation使用start_line,并与max_levels/include_*。
max_lines限制所有模式下的总输出上限;context_lines适用于范围模式(每侧)。参数:
file_path:文件路径。 支持项目相对路径、带有 '..' 的路径、绝对路径、如 /path/lib.jar!/pkg/Foo .class 的归档条目,以及例如 file:// 、 jar:// 和 jrt:// 的 URL。 可以直接传递其他工具返回的任何路径(如来自search_*工具的路径)。mode:读取模式:slice、lines、line_columns、offsets或indentation。start_line:起始读取的 1 基行号。max_lines:要返回的最大行数(切片模式将作为行数使用;所有模式都会限制输出)。end_line:lines/line_columns模式的 1 基结束行号(lines为包含,line_columns为不包含)。start_column:line_columns模式的 1 基起始列号。end_column:范围读取的 1 基结束列号(不包含)。start_offset:偏移模式的 0 基起始偏移量(需end_offset)。end_offset:偏移模式的 0 基结束偏移量(不包含)。context_lines:范围每侧要包含的上下文行数max_levels:缩进模式:包含的最大缩进级别数(0 = 仅锚定块)。include_siblings:缩进模式:包含同一缩进级别的兄弟块。include_header:缩进模式:包含锚点正上方的头部注释/注解。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
重构工具
- rename_refactoring
重命名指定文件中的符号(变量、函数、类等)。 使用此工具执行重命名重构操作。
与简单的文本查找并替换不同,
rename_refactoring工具是理解代码结构的上下文感知型实用工具。 它会智能更新整个项目中对指定符号的所有引用,确保代码完整性并防止引用失效。 它始终是重命名编程符号的首选方法。如果重命名操作成功,该工具将返回成功消息;如果找不到文件或符号,或重命名操作失败,则返回错误消息。
参数:
pathInProject:相对于项目根目录的路径。symbolName:要重命名的符号名称。newName:符号的新名称。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
搜索工具
- 搜索文件
在项目中通过 glob 模式搜索文件。 当需使用 glob 语法匹配文件路径时,请使用该工具。
Glob 模式是相对于项目根目录的。
示例:
"**/*.kt""src/**/Foo*.java""build.gradle.kts"
不含
'/'的模式将被视为"**/pattern"。paths是相对于项目根目录的可选附加 glob 筛选器。参数:
q:要搜索的 glob 模式。paths:可选的项目相对 glob 模式列表,用于筛选结果。 支持!排除。 结尾/会扩展为**。 不含/的模式将被视为**/pattern。 空字符串会被忽略。includeExcluded:是否在结果中包含被排除/忽略的文件。limit:要返回的最大结果数。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 正则搜索
在项目文件中搜索正则表达式匹配项。 当需使用正则表达式并返回代码段结果时,请使用该工具。 结果中包含匹配坐标(如有):1 基行/列,0 基偏移。
路径是相对于项目根目录的 glob 模式。
示例:
["src/**", "!**/test/**"]["**/*.kt"]["foo/"]
参数:
q:要搜索的正则表达式模式。paths:可选的项目相对 glob 模式列表,用于筛选结果。 支持!排除。 结尾/会扩展为**。 不含/的模式将被视为**/pattern。 空字符串会被忽略。limit:要返回的最大结果数。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 搜索符号
搜索符号(类、方法、字段)。 标识符片段进行语义查找时请使用该工具。 结果中包含匹配坐标(如有):1 基行/列,0 基偏移。
路径是相对于项目根目录的 glob 模式。
默认情况下,仅搜索项目符号。 如未找到合适结果,请使用
include_external=true再次尝试以搜索 SDK 和库符号。参数:
q:符号查询文本。paths:可选的项目相对 glob 模式列表,用于筛选结果。 支持!排除。 结尾/会扩展为**。 不含/的模式将被视为**/pattern。 空字符串会被忽略。include_external:是否包含 SDK 和库符号。 默认情况下为禁用;如无合适结果,请使用include_external=true再试。limit:要返回的最大结果数。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- 搜索文本
在项目文件中搜索文本子字符串。 如需快速文本搜索并返回代码段结果,请使用该工具。 结果中包含匹配坐标(如有):1 基行/列,0 基偏移。
路径是相对于项目根目录的 glob 模式。
示例:
["src/**", "!**/test/**"]["**/*.kt"]["foo/"]
参数:
q:要搜索的文本。paths:可选的项目相对 glob 模式列表,用于筛选结果。 支持!排除。 结尾/会扩展为**。 不含/的模式将被视为**/pattern。 空字符串会被忽略。limit:要返回的最大结果数。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
技能搜索工具
- skill_search
使用显式模式执行统一项目搜索:
file:glob 路径搜索。text:字面内容搜索。regex:正则表达式内容搜索。symbol:语义符号查找。
符号搜索默认聚焦于项目。 如果找不到合适的符号,请使用
include_external=true重试,以同时搜索 SDK 和库符号。参数:
mode(必需):搜索模式:file、text、regex或symbol。q(必需):搜索查询。 对于mode=file,这是 glob 模式。paths:可选的项目相对 glob 筛选器。 支持!排除项和末尾的/。include_external:是否为mode=symbol包含 SDK 和库符号。 默认禁用;如果找不到合适的内容,请使用include_external=true重试。includeExcluded:是否包含已排除或已忽略的文件。 仅支持mode=file。limit:要返回的最大结果数。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
终端工具
- execute_terminal_command
在 IDE 的集成终端中执行指定的 shell 命令。 使用此工具在 IDE 环境中运行终端命令。
重要功能和限制:
在收集输出之前检查进程是否在运行。
将输出限制为 2000 行(超出部分将被截断)。
在指定的超时时间后超时,并发出通知。
除非在设置中启用了 Brave Mode ,否则需要用户确认。
返回的可能响应:
终端输出(超过 2000 行时将被截断)。
如果命令超时,输出将包含中断通知。
针对各种失败情况的错误消息。
参数:
command:要执行的 shell 命令。executeInShell:是否在用户的默认 shell(bash、zsh 等)中执行该命令。 如果该命令是 shell 脚本,或需要保留用户终端的真实环境,则非常有用。 如果设置为false,将以进程方式启动该命令。reuseExistingTerminalWindow:是否重用现有终端窗口,以避免创建多个终端。timeout:超时(毫秒)。maxLinesCount:返回的最大行数。truncateMode:如何截断文本:从开头、中间、末尾截断,或不截断。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
通用工具
- execute_tool
通用工具执行器,可从命令行字符串动态调用特定的 IDE MCP 工具。
参数:
command(必需):包含工具名称和实参的命令行字符串。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
VCS 工具
- get_repositories
检索项目中的 VCS 根目录列表。 在多仓库项目中使用此工具识别所有仓库。
参数:
projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
- git_status
检索当前项目中一个或多个仓库的 Git 状态。 返回 porcelain 风格的索引和工作树状态代码以及摘要计数器。 默认返回所有 Git 仓库。
参数:
repositoryPathRelativeToProject:相对于项目根的可选路径,用于选择单个包含它的仓库。includeUntracked:是否包含未跟踪的文件。includeIgnored:是否包含已忽略的文件。limit:每个仓库返回的最大条目数。projectPath:项目路径。 如已知,请始终提供此值,以减少歧义调用。 如果仅知道当前工作目录,您可以将其用作项目路径。
Rails 专用工具
适用于: RubyMine
- 获取 Rails 路由
检索项目中的 Rails 路由。 结果以分页列表形式返回,并基于包含/排除路径、操作(由限定名称指定)、目录及 HTTP 方法进行筛选。
建议优先使用该工具而非手动代码检查,因为它会对 Rails 路由进行深度分析。
参数:
page:分页页码。page_size:每页项目数。included_route_path_filters:要包含的路由路径模式列表。excluded_route_path_filters:要排除的路由路径模式列表。included_action_fqn_filters:要包含的限定操作名称列表。excluded_action_fqn_filters:要排除的限定操作名称列表。included_action_directory_filters:要包含的操作目录列表。excluded_action_directory_filters:要排除的操作目录列表。min_action_count:路由所需的最小操作数。max_action_count:路由可拥有的最大操作数。included_http_method_filters:要包含的 HTTP 方法列表(GET、POST 等)。excluded_http_method_filters:要排除的 HTTP 方法列表。
- 获取 Rails 模型
检索项目中的 Rails 模型。 结果为分页显示,并可通过 FQN 进行筛选
参数:
page:分页页码。page_size:每页项目数。included_fqn_filters:要包含的 FQN 模式列表。excluded_fqn_filters:要排除的 FQN 模式列表。included_directory_filters:要包含的目录列表。excluded_directory_filters:要排除的目录列表。controller_filter:只包含有或没有对应控制器的模型筛选。
- 获取 Rails 控制器
检索项目中的 Rails 控制器。 结果进行分页,并可按 FQN、目录、视图、抽象状态及对应模型的存在进行筛选。
参数:
page:分页页码。page_size:每页项目数。included_fqn_filters:要包含的 FQN 模式列表。excluded_fqn_filters:要排除的 FQN 模式列表。included_directory_filters:要包含的目录列表。excluded_directory_filters:要排除的目录列表。included_view_filters:要包含的视图筛选器列表。excluded_view_filters:要排除的视图筛选器列表。abstract_filter:筛选只包含抽象、非抽象或所有控制器。model_filter:筛选只包含有或没有对应模型的控制器。
- 获取 Rails 助手
检索项目中的 Rails 帮助程序。 结果进行分页,并可按 FQN 和目录进行筛选。
参数:
page:分页页码。page_size:每页项目数。included_fqn_filters:要包含的 FQN 模式列表。excluded_fqn_filters:要排除的 FQN 模式列表。included_directory_filters:要包含的目录列表。excluded_directory_filters:要排除的目录列表。
- 获取 Rails 视图
检索项目中的 Rails 视图。 结果进行分页,并可按是否为部分视图、布局、控制器关联、路径以及控制器目录/FQN 进行筛选。
参数:
page:分页页码。page_size:每页项目数。partiality_filter:筛选只包含部分视图、非部分视图或两者。layout_filter:筛选只包含布局视图、非布局视图或两者。controller_filter:筛选只包含有关联控制器的视图。included_path_filters:要包含的视图路径列表。excluded_path_filters:要排除的视图路径列表。included_controller_fqn_filters:要包含的控制器 FQN 列表。excluded_controller_fqn_filters:要排除的控制器 FQN 列表。included_controller_directory_filters:要包含的控制器目录列表。excluded_controller_directory_filters:要排除的控制器目录列表。
- 获取 Rails 邮件器
检索项目中的 Rails 邮件程序。 结果进行分页,并可按 FQN 和目录进行筛选。
参数:
page:分页页码。page_size:每页项目数。included_fqn_filters:要包含的 FQN 模式列表。excluded_fqn_filters:要排除的 FQN 模式列表。included_directory_filters:要包含的目录列表。excluded_directory_filters:要排除的目录列表。